Claude Code 分工要清楚:人定目標,agent 做執行
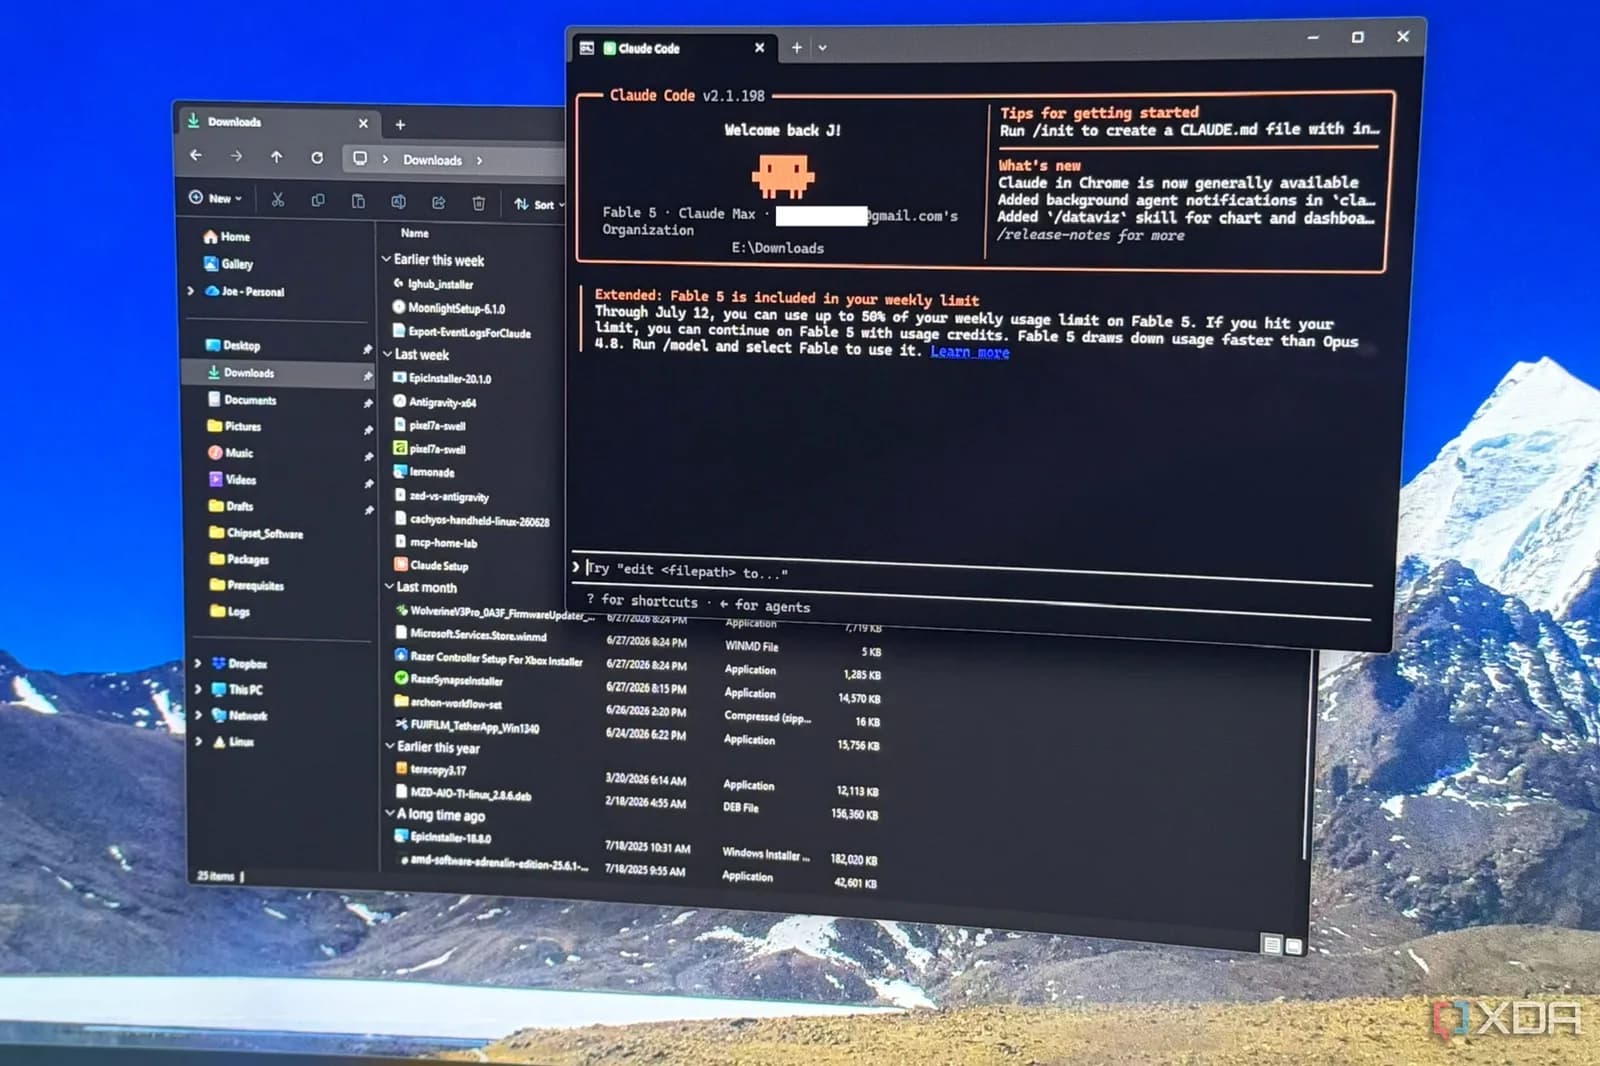
Anthropic 據報分析約 40 萬個 Claude Code 真實工作階段,觀察到較常取得好結果的使用方式,並非使用者逐步指揮 agent 開哪個檔案、改哪行程式、再跑哪一條指令,而是先清楚交代任務目標、背景、限制及成功定義,然後讓 Claude Code 決定執行路徑。對使用 AI 協助寫程式的開發者、學生與小型團隊而言,這提供了一個實用分工:人負責判斷「要甚麼」,agent 負責處理「怎樣做」。不過,這是 Anthropic 的第一方觀察研究,XDA 報道未交代樣本篩選、私隱處理及完整成功判定方法,數字可作工作習慣的參考,不能直接當作所有團隊都會得到同樣效果的因果結論。
報道引述的數據顯示,使用者在被分析的工作階段中作出約七成規劃決定,Claude 則作出約八成執行決定。這個分界很值得重視,因為 agent 的價值在於能串連讀取檔案、修改程式及執行指令等多個動作;若使用者將每一步都預先寫死,agent 的活動空間便會縮小,也會令對話變成逐步遙距操控。實際上,應把 Claude Code 視為可被授權的執行者,但授權範圍必須由人界定,尤其涉及刪改資料、設定權限、改動部署流程或觸及敏感內容時,更要先列出不可碰的範圍。
有效使用的核心:交代成果,不要遙控步驟
XDA 指出,一個典型 prompt 可觸發 Claude 約 10 個動作,包括讀檔、編輯程式碼及執行指令;在部分情況下,動作可超過 100 個。當使用者保留逾八成執行決定時,Claude 每輪約做 8 個動作;而在 Claude 有較大自主空間的工作階段,則可以在再次需要使用者介入前走得更遠。這不代表應把所有控制權交出去。報道亦提到,當 Claude 作出逾八成「規劃」決定時,每輪約有 16 個動作,但執行更長不等於結果必然更好,特別是任務本身的方向錯誤時,錯誤也可能被更有效率地放大。
較穩妥的做法,是把 prompt 寫成一份小型工作說明書:先講清楚產出,再補上系統背景、不能違反的規則、可接受的改動範圍,以及驗收方法。例如優化一個系統時,與其指定逐個資料夾、程序與指令,不如說明希望改善甚麼表現、不可影響哪些功能、可動用甚麼工具,並要求在改動前列出計劃、在完成後提交證據。這種寫法保留 agent 探索及執行的能力,同時讓使用者在真正重要的判斷點把關,不用每一步都管得太細。
可直接套用的 prompt 骨架如下:
- 目標:完成「具體成果」,例如修正某個可重現的錯誤,或把某頁面調整至符合既有參考。
- 背景與範圍:說明相關模組、現有行為、可修改與不可修改的檔案或設定。
- 限制:列明不可改變的介面、相容性要求、資料處理規則,以及不可執行的破壞性操作。
- 執行授權:要求 agent 自行檢查所需檔案、提出合理改動並運行相關檢查;重大取捨或超出範圍的改動先停下詢問。
- 驗收證據:指定要通過哪個測試、展示甚麼設定狀態、提供哪些改動摘要與未解決風險。
圖片:Wikimedia Commons 檔案頁 — Marine BAJAN (CC BY-SA 4.0)
專業知識仍是驗收能力
這項研究並沒有把「專家」簡化為懂得寫更多程式的人。報道以會計為例:即使對方不會寫 Python,只要了解對帳規則、知道邊界情況在哪裡,並能看出 script 是否誤處理例外,仍可在該工作階段扮演專家角色。這對採用 AI 的非工程職能尤其有啟發:入門門檻或許下降,但領域規則、風險判斷與品質標準沒有消失,只是由親手實作轉為定義問題和審核結果。
按 XDA 所述,初學者工作階段中,每個 prompt 平均引發約 5 個 Claude 動作及約 600 字輸出;專家工作階段則約為 12 個動作及 3,200 字。報道稱差距在不同工作類型及任務價值區間均存在,並推斷較有經驗者較能提供足夠脈絡、方向與操作空間。這個解讀合理,但仍應避免倒推成「輸出愈長、動作愈多便愈專業」。對實際團隊來說,更可靠的指標是任務是否可重現、改動是否可追蹤、測試是否通過,以及風險是否已被說清楚。
用可證明的檢查取代「你確定嗎」
報道另一個重點是驗證方式。初學者常要求 Claude「再檢查一次」或「你確定嗎」,但這其實仍是要求同一個系統評價自己的工作。較成熟的做法是把驗收條件外顯化:修正 bug 時,先提供可重現錯誤的測試,並要求改動後測試必須通過;調整 UI 時,提供參考及檢視結果的方法;修改設定時,要求展示最終狀態;處理資料邏輯時,則要求列出關鍵輸入、預期輸出及邊界個案。
一套可用的審核流程可以很簡單:首先要求 Claude 在動手前覆述目標、限制與預計驗證方式,讓使用者及早發現 agent 是否理解錯誤;完成後,要求它交代改了哪些檔案、執行了哪些檢查、結果如何,以及有哪些未驗證項目;最後由使用者按預先定義的業務規則、測試結果或畫面參考作獨立確認。這樣的流程不保證 agent 永不出錯,但把「它說完成了」轉換成可檢查的證據,亦較容易納入 code review 或課程作業的既有習慣。
出錯後的價值,在於能否拉回正軌
Anthropic 的觀察亦顯示,遇上明確失敗跡象後,較有經驗的使用者更可能把工作階段救回來。報道稱,在已有驗證失敗證據的工作階段中,初學者最終達成已驗證成功的比例約 4%,專家約 15%;部分成功方面,初學者約 60%,中級及以上使用者約 80%。初學者放棄問題工作階段的比例約 19%,其他組別則約 5% 至 7%。這些比例反映相關性,未足以證明熟練程度單獨造成結果差距,但指出一項值得培養的能力:辨認問題究竟是需求不清、環境限制、測試錯誤,還是 agent 假設錯了,然後用新證據把任務收窄。
當 Claude Code 偏離方向時,與其只說「重做」或不斷重複原 prompt,較有效的修正是指出失敗證據,重申不可違反的條件,再要求它提出最小改動方案和新的驗證步驟。例如可要求它保留現有介面、只處理已重現的失敗案例,並先解釋先前假設為何與測試結果矛盾。這既可減少無止境修改,也讓使用者建立自己的故障排查框架。
對正在把 agent 納入日常開發的人,下一步值得觀察的是團隊能否把目標、限制、驗收及介入點寫成共同模板,而非只依賴個別高手的 prompt 習慣。隨着更多工作由 agent 執行,懂得定義好結果、提供可驗證證據,以及在失敗後重新收窄問題的人,仍會是流程中最關鍵的一環。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理,並經兩輪獨立自動品質審核;資料及連結仍以原始來源為準。
參考來源
- XDA Developers — Anthropic analyzed 400,000 Claude Code sessions, and it turns out there's a right way to use it — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。