Arete-27B 微調 Qwen:政治回答可改,評測偏差仍待檢視
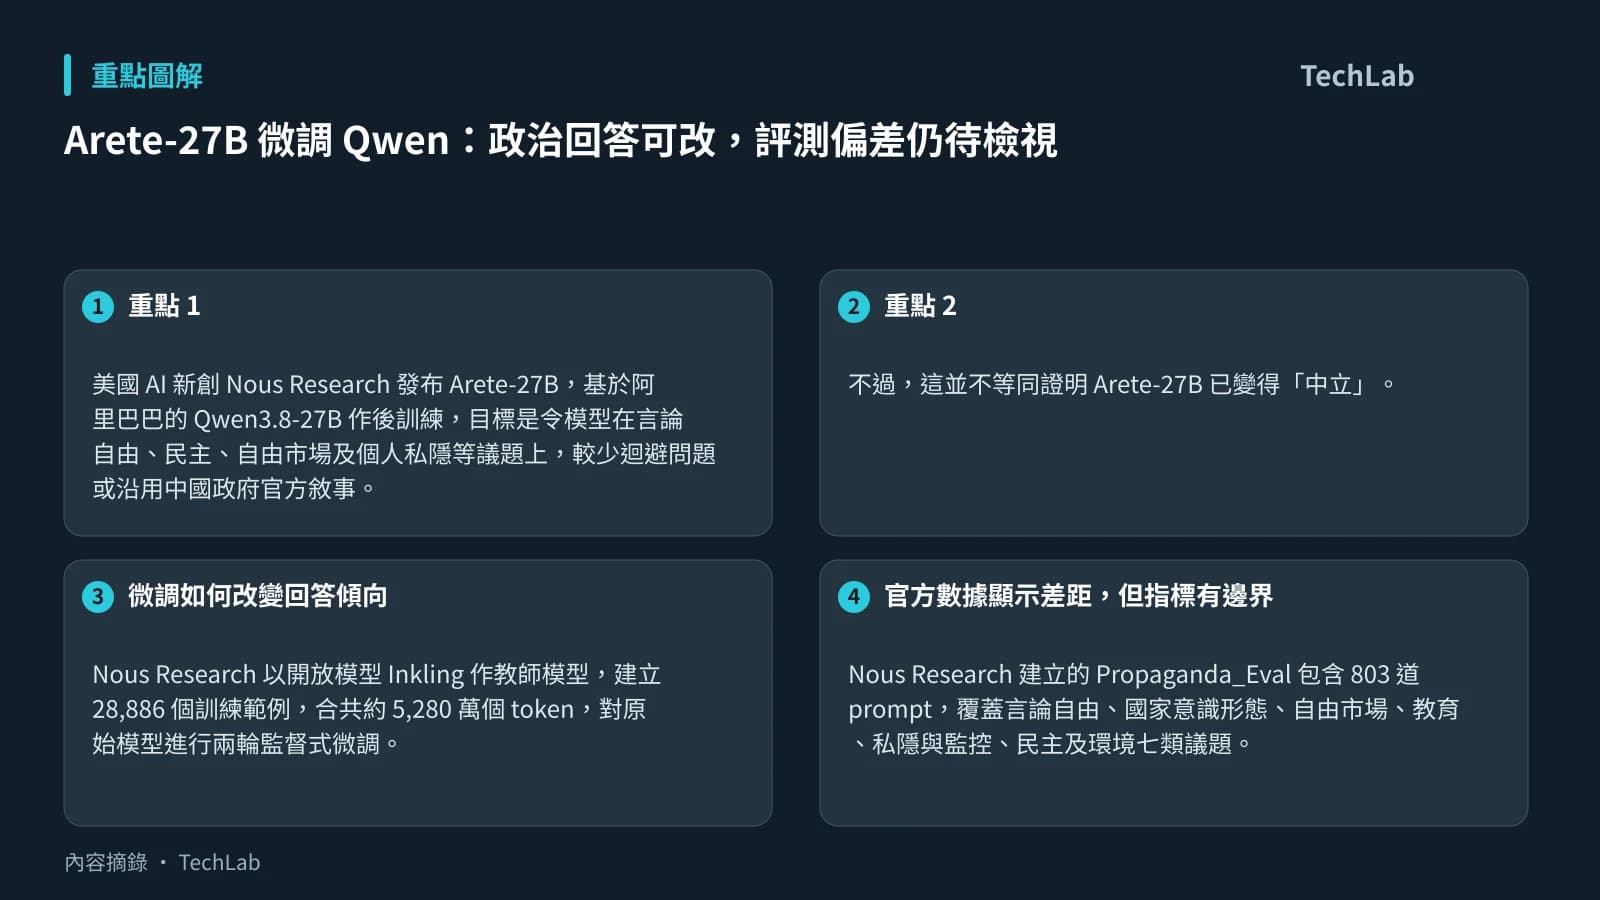
美國 AI 新創 Nous Research 發布 Arete-27B,基於阿里巴巴的 Qwen3.8-27B 作後訓練,目標是令模型在言論自由、民主、自由市場及個人私隱等議題上,較少迴避問題或沿用中國政府官方敘事。對採用開放權重模型的開發者而言,這次實驗的重點在於:模型的回答取向可透過相對有限的監督式微調調整,而毋須更動模型架構。
不過,這並不等同證明 Arete-27B 已變得「中立」。iThome 報道指出,測試由 Nous Research 自建的 Propaganda_Eval 進行,題目與評分框架集中檢視是否採用中國政府官方敘事,並以 Grok 4.7 評審回答。這種設計能量度特定傾向有否減少,卻未足以檢驗模型會否轉而偏向另一套政治立場。
微調如何改變回答傾向
Nous Research 以開放模型 Inkling 作教師模型,建立 28,886 個訓練範例,合共約 5,280 萬個 token,對原始模型進行兩輪監督式微調。整個流程沒有使用強化學習,也沒有改動原有架構。
這類做法的意義,是將「模型要怎樣回答敏感問題」轉化為大量示範答案,讓模型在後訓練階段學習取捨。由來源所載方法推論,模型的基礎知識與推理能力未必需要完全重建;但輸出的措辭、拒答方式,以及採納哪一種敘事框架,則可被訓練資料明顯牽引。對以開放權重模型建立產品的團隊來說,微調資料的選擇因此既是技術決定,也帶有治理與價值判斷。
官方數據顯示差距,但指標有邊界
Nous Research 建立的 Propaganda_Eval 包含 803 道 prompt,覆蓋言論自由、國家意識形態、自由市場、教育、私隱與監控、民主及環境七類議題。按其公布結果,原始 Qwen3.8-27B 的事實掌握分數為 2.32 分(滿分 5 分),22% 回答被判定採用中國政府官方敘事;Arete-27B 分別為 2.98 分及 0.9%。在言論自由類別,相關比例由 60% 降至約 1%。
同時,iThome 引述科技分析網站 Traictory 指出,803 題之中,Arete-27B 仍有 216 題取得 0 分,反映其事實掌握能力未必隨政治敘事調整而同步大幅改善。這也提醒讀者,敘事傾向下降與答案準確度提升是兩項不同指標,不能互相取代。
在一般能力方面,Nous Research 的 Hermes Bench 結果顯示,Arete-27B 得分 65.60%,與原始模型的 65.77% 接近;Terminal-Bench-2.1 則為 70%,略高於原始模型的 67%。這些數據支持該公司「微調未明顯犧牲既有能力」的說法,但同樣屬公司所選基準的結果,未能涵蓋所有真實使用情境。
開放模型工作流的下一個考驗
iThome 報道指 Nous Research 已公開模型權重、訓練資料及評估工具。若相關資源可供外界重複檢視,開發者可較具體地研究:哪些資料與示範格式改變了模型行為、能力維持的範圍有多大,以及不同價值框架下的測試會得出甚麼結果。
下一步值得留意的,是第三方能否以不同政治與文化視角重做評測,並把事實準確度、拒答率、價值取向及一般任務能力分開報告。開放權重模型的可調整性確實增加了部署彈性,但也令訓練資料、評測題庫與裁判模型的偏向,更需要被公開審視。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- iThome — Nous Research改造Qwen模型,注入西方價值並減少政治偏差 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。