本機跑 LLM、打機卡頓:GPU Taskman 拆解 VRAM 去向
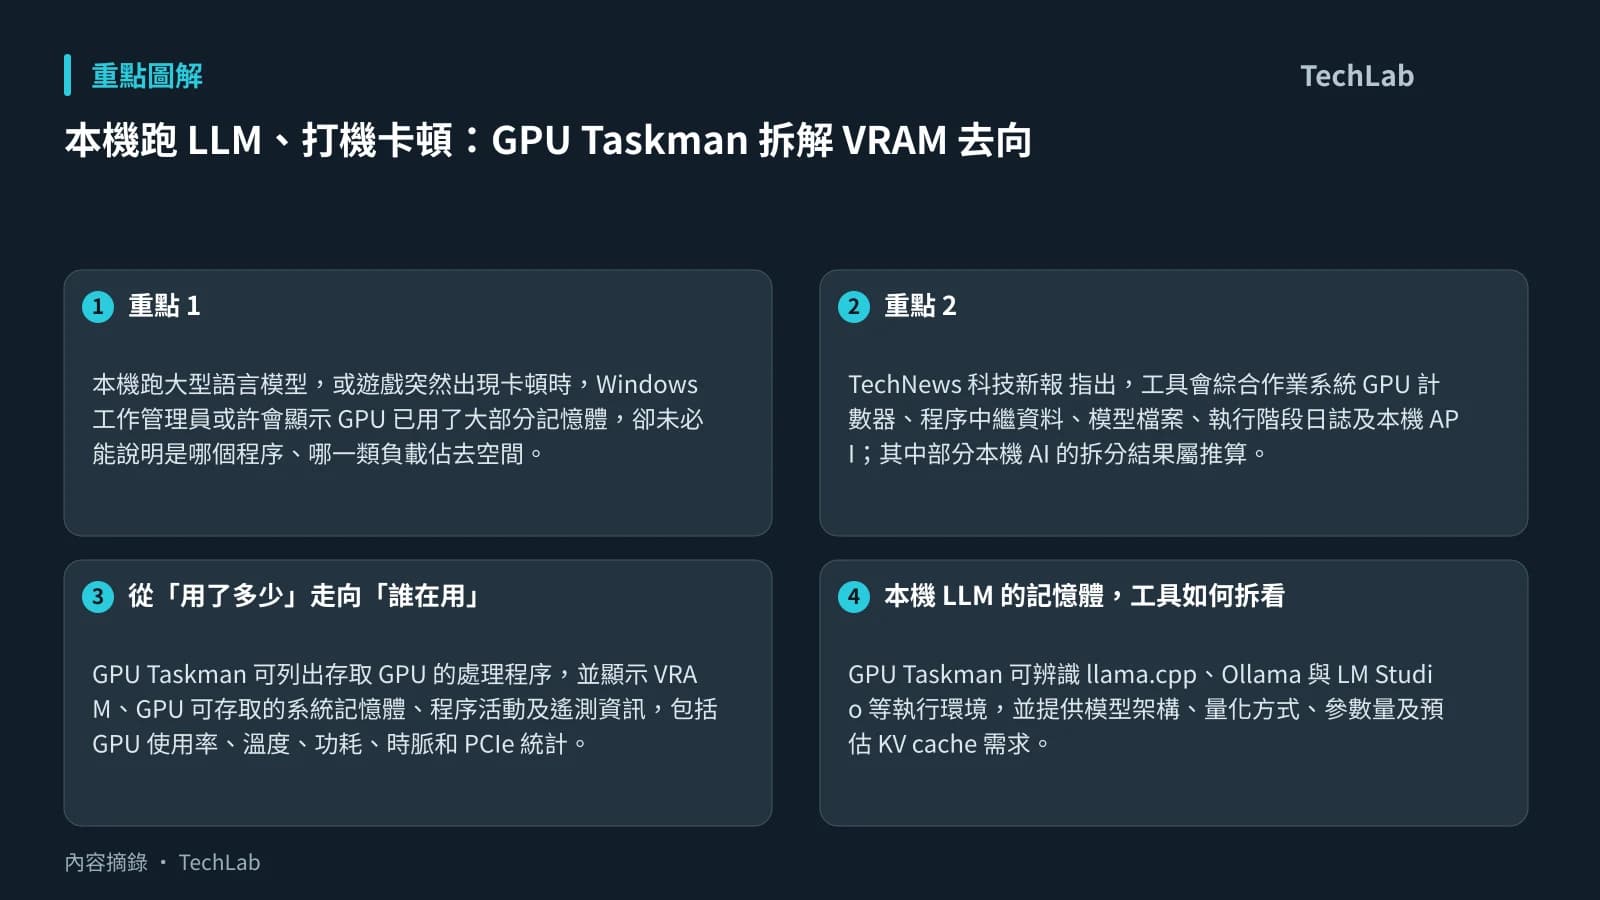
本機跑大型語言模型,或遊戲突然出現卡頓時,Windows 工作管理員或許會顯示 GPU 已用了大部分記憶體,卻未必能說明是哪個程序、哪一類負載佔去空間。TechNews 科技新報 報道,微軟暨 GitHub 副總裁 Scott Hanselman 推出開源終端機工具 GPU Taskman(gputaskman),目標正是把這個總數拆成較可理解的程序與工作負載。
不過,這不應被視為 VRAM 的硬體級精密帳本。TechNews 科技新報 指出,工具會綜合作業系統 GPU 計數器、程序中繼資料、模型檔案、執行階段日誌及本機 API;其中部分本機 AI 的拆分結果屬推算。它也提醒,GPU 可存取的系統記憶體不等同於 VRAM 溢位。
從「用了多少」走向「誰在用」
GPU Taskman 可列出存取 GPU 的處理程序,並顯示 VRAM、GPU 可存取的系統記憶體、程序活動及遙測資訊,包括 GPU 使用率、溫度、功耗、時脈和 PCIe 統計。桌面合成器、瀏覽器、遊戲與 AI app 等不同負載,可望不再只被歸入單一 GPU 用量數字。
這對排查問題的價值,在於縮小懷疑範圍。使用者若在啟動模型或遊戲後看見記憶體壓力上升,可先比對哪個程序活躍,再觀察 VRAM 與 GPU 可存取系統記憶體的變化。若瀏覽器、桌面合成或其他背景程序同時佔用資源,便較容易辨認它們是否與前景工作競爭。
但這種觀察不能直接推導成某個遊戲「爆 VRAM」或某個程序吃掉特定材質。TechNews 科技新報 報道,Hanselman 已說明工具無法識別個別遊戲材質;而系統記憶體數字本身也不能單獨證明 VRAM 已不足。對玩家而言,它較適合作為定位線索,仍要配合遊戲內設定和實際卡頓情況判讀。
本機 LLM 的記憶體,工具如何拆看
GPU Taskman 可辨識 llama.cpp、Ollama 與 LM Studio 等執行環境,並提供模型架構、量化方式、參數量及預估 KV cache 需求。其用途是把模型工作負載分成幾個更接近使用情境的部分:模型權重、KV cache 與運算緩衝區。
| 項目 | 在工具中的意義 | 判讀限制 |
|---|---|---|
| 模型權重 | 模型載入後所需的主要記憶體部分 | 依模型檔案等資料判讀,並非所有數字均為直接量測 |
| KV cache | 推論過程保存上下文所需的預估空間 | 屬預估需求,不能視作固定的硬體計數 |
| 運算緩衝區 | 模型執行期間的運算相關記憶體 | 與執行環境及當前工作負載有關 |
| GPU 可存取系統記憶體 | GPU 可使用的系統記憶體用量 | 不等於 VRAM 溢位 |
因此,對常在電腦上切換不同模型的人來說,這類拆分可協助理解「模型很大」以外的差異:同一張 GPU 的壓力,可能來自載入的模型權重,也可能與 KV cache 或其他程序同時活動有關。這是根據工具所呈現分類作出的使用分析,並不表示工具能精準還原每一個記憶體配置細節。
支援範圍與下一步
據 TechNews 科技新報 報道,GPU Taskman 支援 Windows 10/11 的 NVIDIA 與 AMD 顯示卡,也涵蓋 Linux、WSL 和 Apple Silicon 架構的 macOS;v0.3.5 新增 Linux Intel GPU 支援,以及 CPU 和系統記憶體監控。工具採 MIT 授權,可從 GitHub 或 PyPI 取得,Windows 可攜版毋須另裝 Python。
它目前仍屬實驗性軟件,功能與支援範圍可能快速調整。接下來較值得觀察的是,發布者能否讓不同 GPU、作業系統與本機 AI 執行環境的數據判讀更一致;對本機 AI 使用者和電腦玩家而言,這將決定它能否由排查輔助工具,逐步成為日常監察 GPU 資源的選項。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- TechNews 科技新報 — GitHub 副總裁推開源 GPU 工作管理員,幫你揪出是誰在用顯卡記憶體 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。