
#本機 AI
83 篇文章
TechLab 所有關於「本機 AI」嘅文章、評測同教學,由最新排起。
 3C 產品
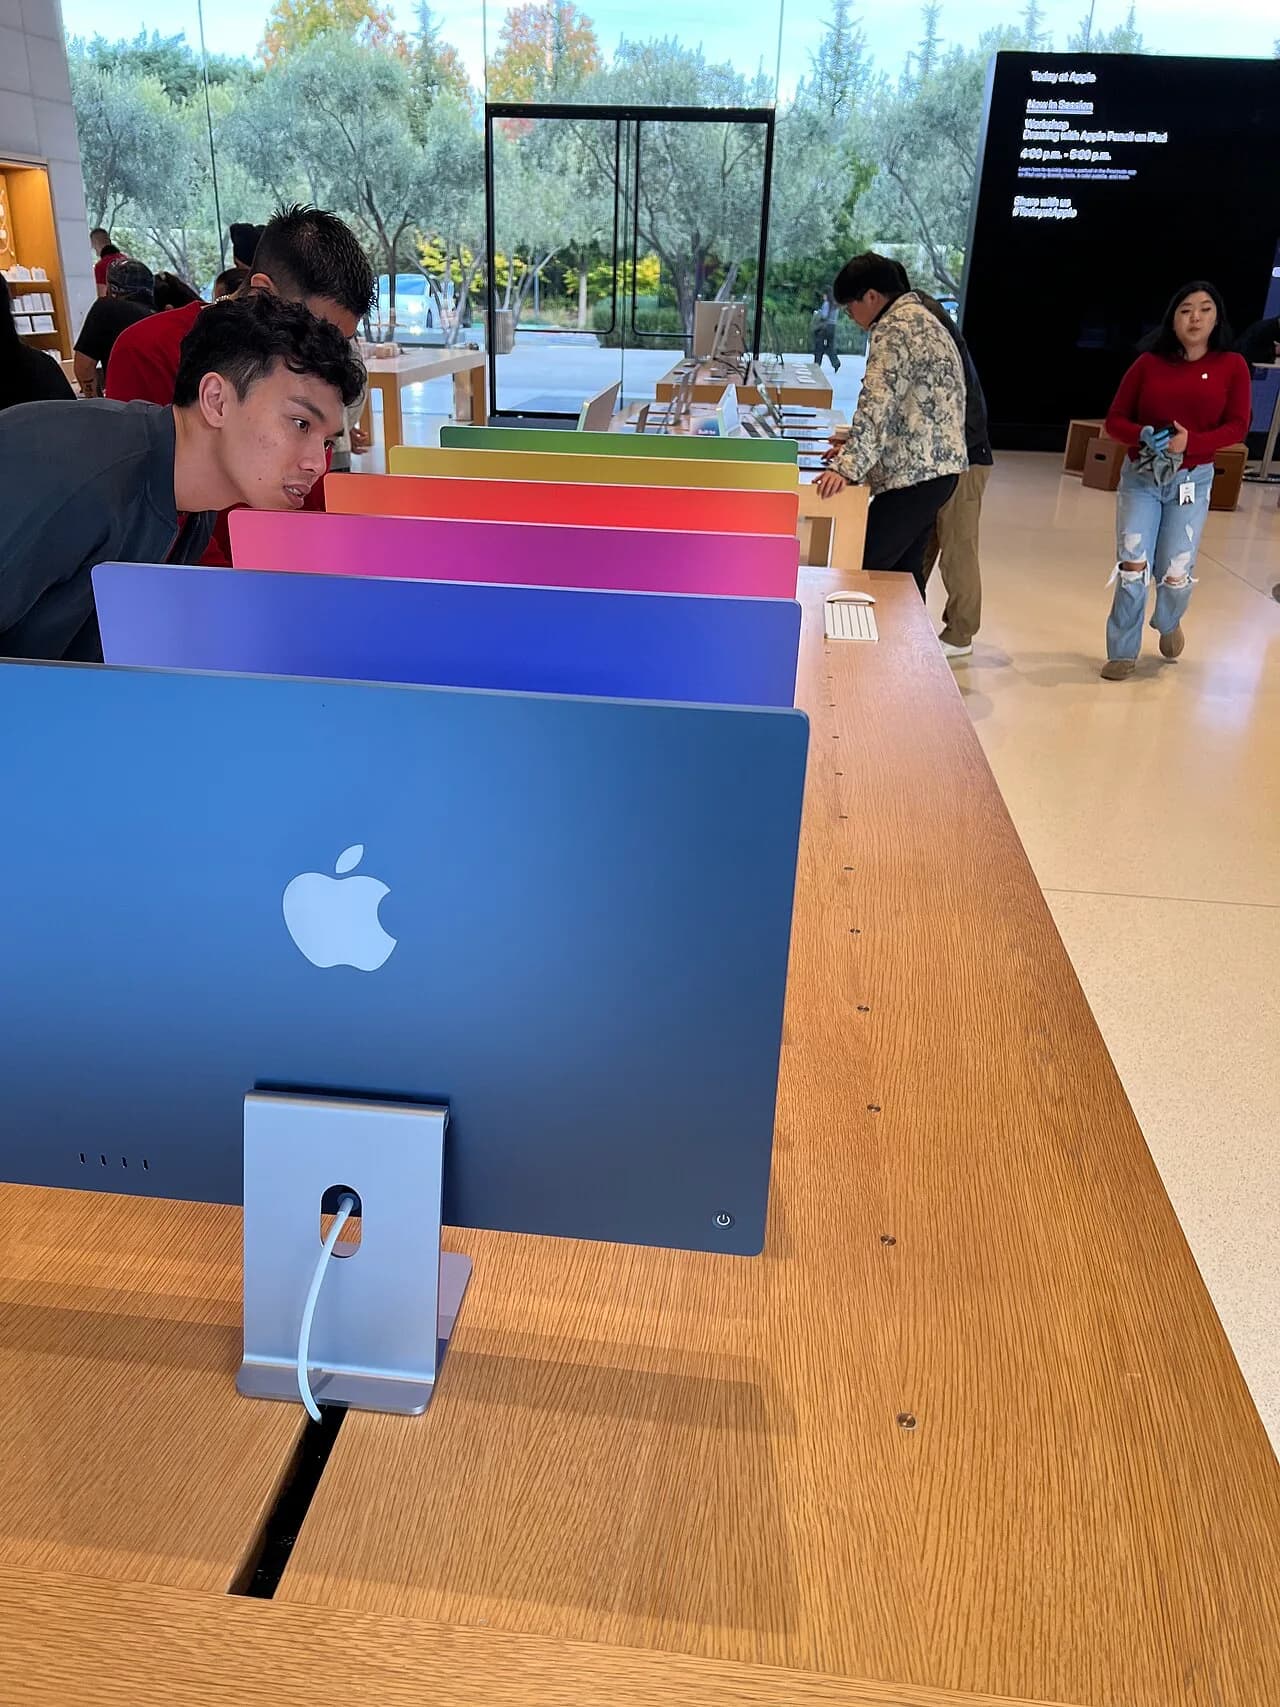
M4 iMac 升 M6:本機 AI 與外接螢幕才是分水嶺
M6 iMac 把本機模型處理、SSD、Wi‑Fi 7 與高更新率外接螢幕推前一步;不過對多數 M4 用戶,日常使用未必構成換機理由。
 Tech News
Block 發表 Dessa:以語音直連語音的 AI 對話實驗
Block 稱 Dessa 從人類對話聲音訓練,主打語音情緒和即時互動,並可在 M4 Max MacBook Pro 或更高階機種本機運行;目前只向少量 AI 安全研究者開放早期存取。
 3C 產品
Perplexity Computer 登陸全本機 Mac:私隱工作流仍有邊界
Perplexity 將 Computer 的模型推理、任務規劃及檔案處理搬到支援 Apple silicon 的 Mac 本機,但 36GB 記憶體只是建議值;要用即時資料、瀏覽器或雲端 app,仍須由用戶授權連接雲端。
 3C 產品
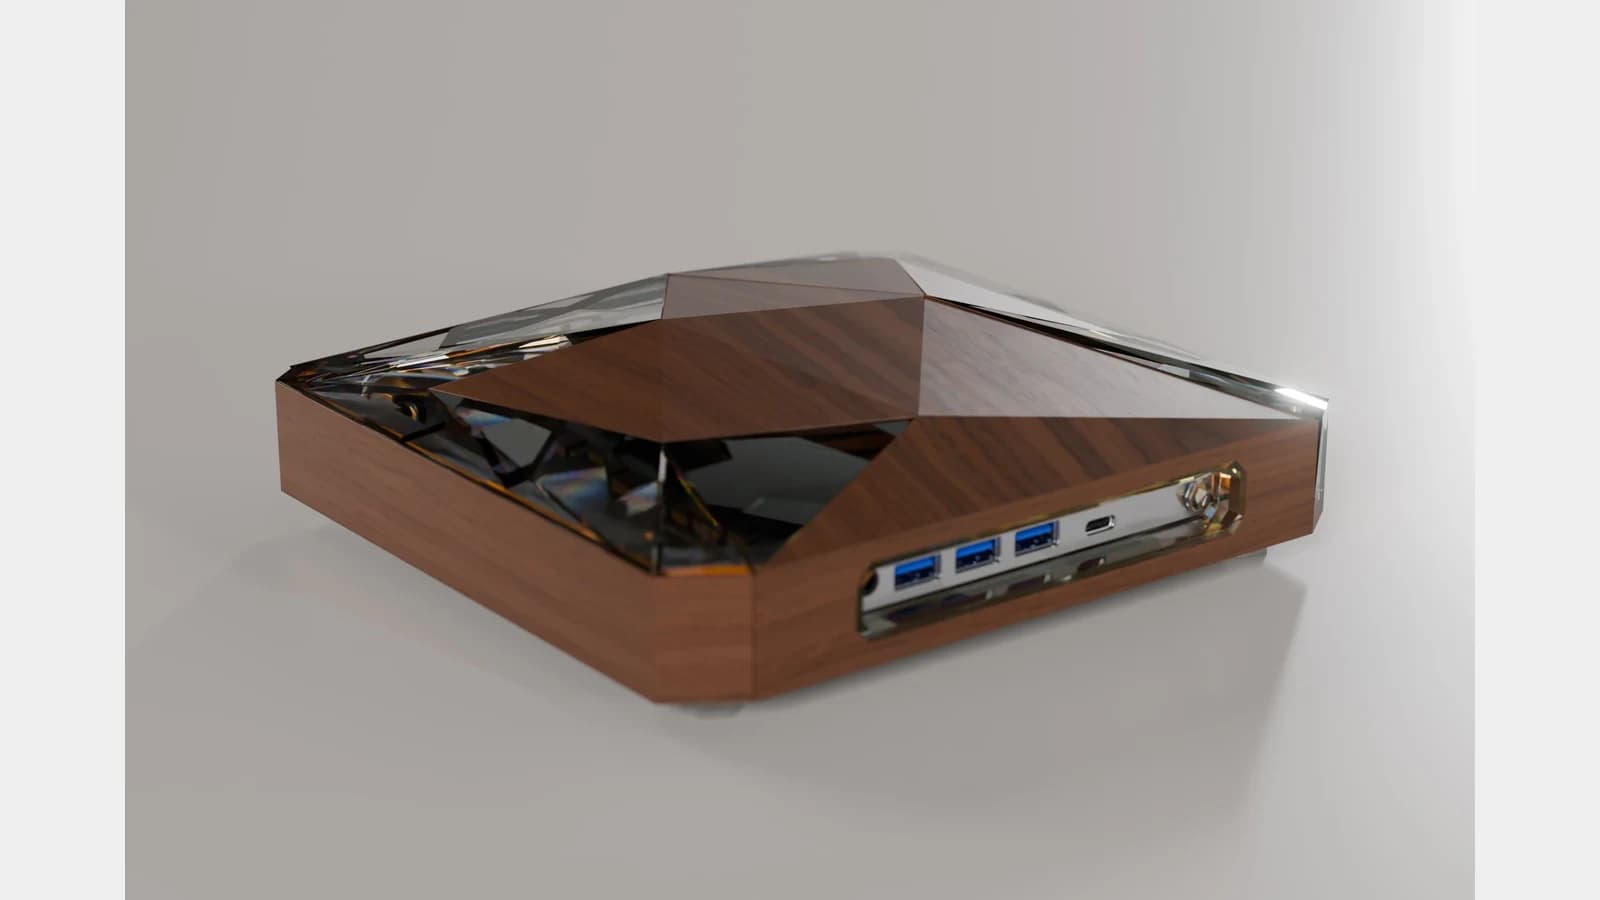
Janus One 私人 AI 主機叫價 US$7,999:把助理與文件庫搬回家
Janus One 配備 128GB RAM、2TB 儲存,主打本機 AI 助理。從私人資料管理、免按用量收費到保留模型,看看這套家居 AI 系統的吸引力。
 3C 產品
本機 AI 部署取捨:llama.cpp 為何適合進階 MoE 調校
XDA 一項單機比較顯示,Ollama 與 llama.cpp 的速度未必相差很遠;真正分野在於能否按 MoE 模型、VRAM、系統記憶體及 context 配置作細緻調校。
 Tech News
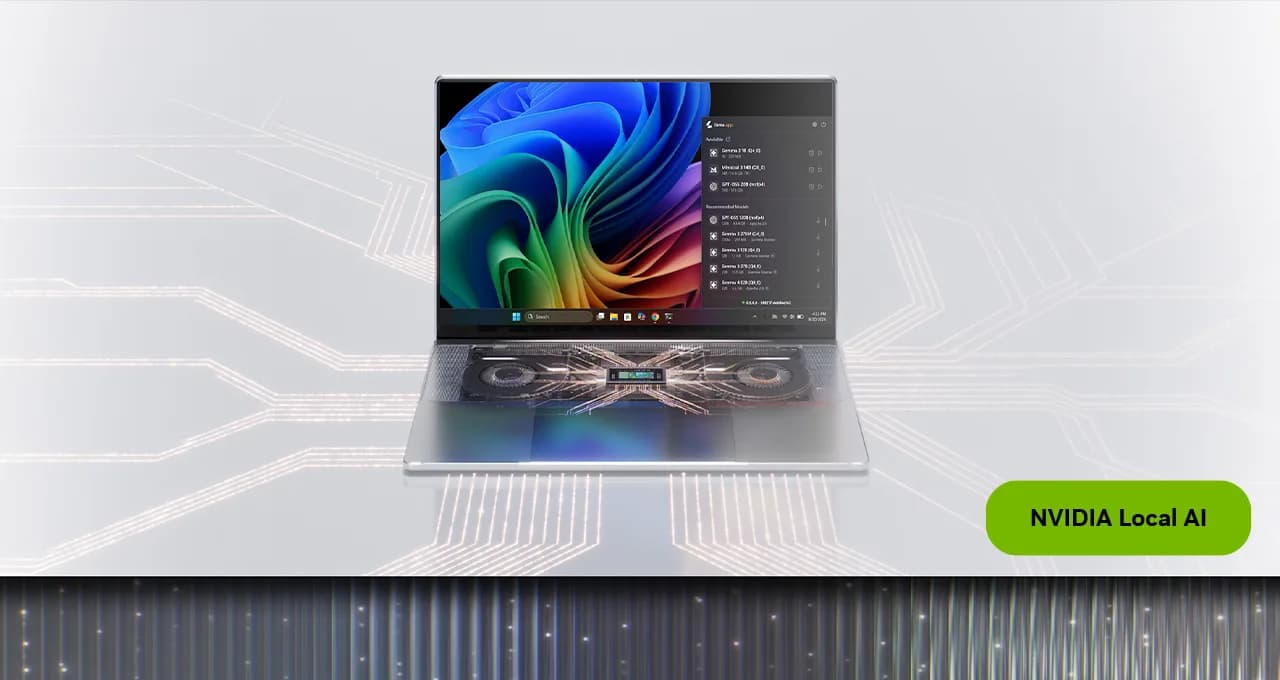
RTX Spark 能否令 Windows 筆電追上 Apple Silicon?關鍵仍在軟件與實測
RTX Spark 把 Arm CPU、Blackwell GPU 與大量統一記憶體放進單一晶片,瞄準本機 AI、流動創作及遊戲;不過其高價、x86 模擬與遊戲相容性,仍是 Windows 用戶採用前要先看清的限制。
 3C 產品
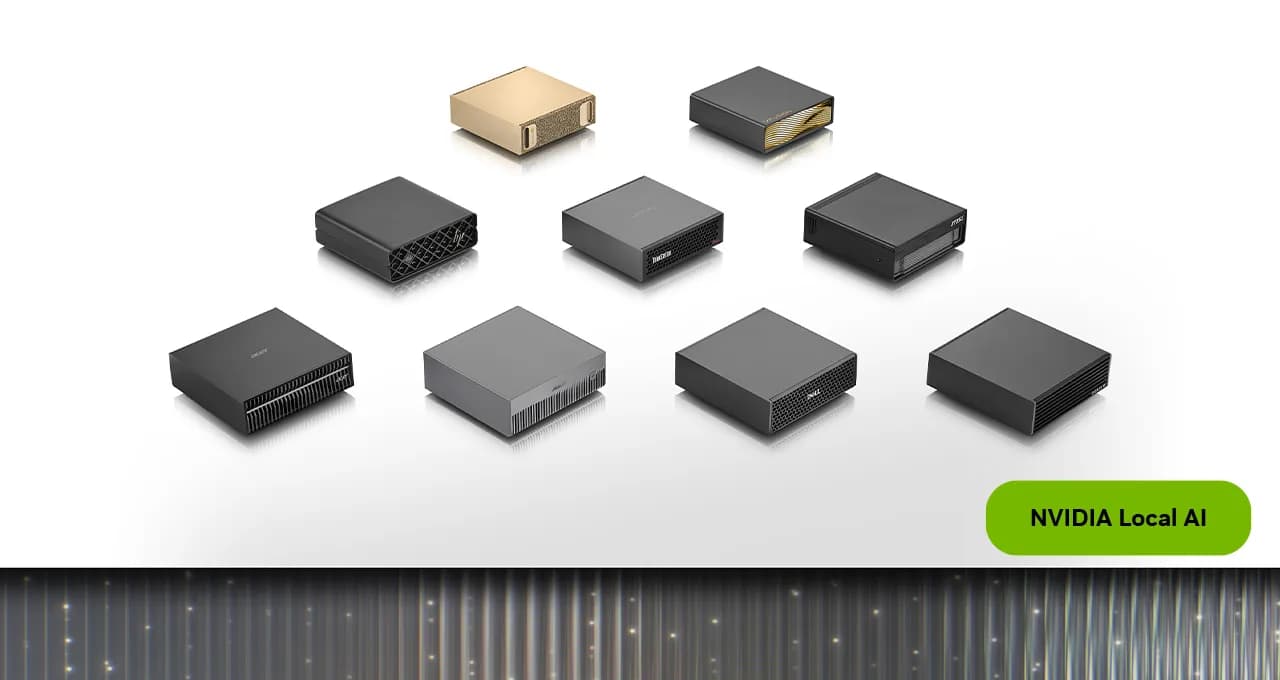
DLSS 5 在 DGX Spark 跑得動,仍未能預告 ARM Windows 遊戲表現
XDA 以 DGX Spark 的非原生環境測試經修改的 DLSS 5,畫面設定下仍可運行,但數字更說明 ARM Windows 筆電的遊戲相容性與效能仍待正式驗證。
 3C 產品
Google 推出 Foresight:Mac 本機 AI 會議筆記的私隱取捨
Google 據報推出 AI Edge Foresight for Mac,以離線錄音、速記補全及本機文件問答處理個人知識;實用性取決於 Mac 效能、檔案整理與會議資料管治。
 3C 產品
HP 推 RTX Spark 筆電與小型桌面電腦,瞄準本機 AI 長時間任務
HP 發表 OmniBook Ultra 16、OmniBook X 14 及 OmniDesk,將本機 AI、流動工作與長時間 agent 任務分拆到不同裝置。不過散熱、實際續航與定價,仍是判斷其能否減少雲端依賴的關鍵。
 Tech News
Project Zenith 預載 Windows 開發工具,64GB RAM 門檻限制普及
Microsoft 的 Project Zenith 以較少干擾的 Windows 設定和預載工具吸引開發者,但首批要求 64GB RAM,令本機大模型開發的便利與硬件門檻成為焦點。
 3C 產品
Android 17 私隱儀表板加入本機 AI 記錄:100MB 與 12 小時限制怎樣看
Android 17 QPR2 Beta 4 為 Private Compute Core 加入資料記錄選項。它提升透明度,但詳細記錄可能包含敏感個人資料,一般用戶未必需要長開。
 Tech News
Perplexity 推本機 AI 代理:24GB VRAM 換來多少私隱與成本優勢?
Portable Computer 把代理式 AI 工作流搬到 Linux 電腦,但 24GB VRAM、有限模型選擇及雲端升級機制,令其成本與私隱優勢仍有待驗證。
 Tech News
Unsloth Dynamic v3.0 同容量留多啲精度,本機跑 Qwen 有咩實際分別
Dynamic v3.0 用新校準資料重新判斷邊啲模型層最怕壓縮,令 GGUF 喺相若容量下少失一截精度。首個版本落喺 Qwen3.8-27B,Ollama、LM Studio 同 llama.cpp 都用得,不過官方暫時冇交代 token 速度,準確率數字亦未有獨立測試確認。
 3C 產品
16GB RAM 輕薄 notebook 跑本機 LLM:四個模型做到咩、卡喺邊
XDA 作者用一部 16GB RAM、AMD Radeon 整合顯示核心嘅 Lenovo notebook 跑四個量化 LLM,寫作、摘要同細型 coding 工作都做到。不過原文冇公開 token 速度同完整設定,結果更適合當入門方向,未足以當成通用 benchmark。
3C 產品兩部 DGX Spark 跑 DeepSeek V4 Flash:所謂追上雲端講緊邊樣?
XDA 用兩部 NVIDIA DGX Spark 分擔 284B 參數嘅 DeepSeek V4 Flash,輸出升到每秒 36 至 41 token,寫 code 一度衝上 76。不過「追上雲端」主要係指模型毋須再壓到 2-bit,加上作者主觀使用感受,未有完整質素或雲端速度對照。
 Tech News
WhatsApp Scam Alert 本機睇可疑訊息:私隱守得住,廣東話識唔識仍未明
WhatsApp 測試 Scam Alert,用手機本機模型分析陌生人傳入嘅訊息,見到可疑模式就彈警告,再畀用家封鎖、舉報或者照傾。設計上冇將訊息交畀 Meta 分類,不過香港推出時間、平台同廣東話準確度全部未有答案。
Tech NewsUnsloth Desktop 接通本機 LLM 同 Codex:慳 API 費用要先過硬件一關
Unsloth Desktop 將模型下載、推理、微調同 API endpoint 集中喺同一個介面,仲可以接駁 Codex 同 Claude Code。本機處理敏感程式碼確實吸引,亦有機會慳返部分雲端 API 費用,不過模型能力、RAM/VRAM 同推理速度,會直接決定佢有幾實用。
3C 產品本機 LLM 將 PDF 變私人溫習助手:私隱夠吸引,答案仍要逐頁核對
XDA 作者用 Ollama、Gemma 4 E4B 同 ChromaDB,將講義、PDF 同筆記變成離線問答及出題工具。資料留喺自己部機確實吸引,不過原文冇交代完整硬件規格、準確率或學習成效;RAG 亦只係減少幻覺,答案仍要睇返頁碼逐項核對。
3C 產品AI 模型蒸餾點令 coding model 塞得入 laptop?同量化差喺邊
模型蒸餾會用大型 teacher 嘅輸出訓練細型 student,量化就壓低權重精度,兩招其實可以疊住用。對本機 coding model 嚟講,呢套組合直接影響速度、答案質素、RAM 需求,同埋公司程式碼使唔使離開部機。
 Tech News
Meta Muse Glimmer 單機跑 AI agent:24GB VRAM 先算入場
Meta 推出可喺本機運行嘅 Muse Glimmer 30B,主打 coding、工具調用同多步工作。不過所謂「一部電腦跑到」門檻唔低:最細量化版都要預 24GB VRAM,llama.cpp 支援亦未正式合併。
3C 產品Qwen 3.6 本機做到 vibe coding,樽頸落喺 context 同工具設計
XDA 用 RX 7900 XTX 本機跑 Qwen 3.6 27B,再接駁 Tines 3B 寫 RSS app。今次結果顯示,呢個 27B 本機模型跟到規格,亦識試 code 同修 bug;實際限制主要來自 context 管理、測試工具同 credentials 權限。
 3C 產品
Chrome 本機 AI 模型會自動下載:20GB 門檻、點查容量同關閉
Chrome 會喺合資格電腦背景下載本機 AI 模型,Google 要求預留約 20GB 空間,開發者文件就寫至少 22GB。不過呢兩個數字都係安裝門檻,唔代表模型硬食咁多容量。以下講清楚點查實際大小、點停用,同點解關咗之後 Gemini 功能仍可能出現。
3C 產品Kimi K3 開放權重但難稱本機 AI:一般開發者點樣先用得着
Moonshot AI 公開 Kimi K3 全套權重,模型表現亦貼近頂級封閉模型。不過成套檔案約 1.56TB,正式部署要多張數據中心 GPU。對一般開發者嚟講,API 仍然最易用;開放權重真正吸引之處,係企業可以控制部署環境、模型版本同資料流向。
3C 產品Ollama 加 n8n 管盡 homelab:四道安全閘點樣設得穩陣
有人用 Qwen、Ollama、Open WebUI、Home Assistant MCP 同自架 n8n,砌咗個完全本機運行嘅 homelab 助手。成套架構真正值得參考嘅地方,係點樣限制工具、分開讀寫權限、攔住高風險操作,同核實資料有冇離開屋企網絡。