Google 推兩款 TPU 系統,企業 AI 轉向安全與長上下文
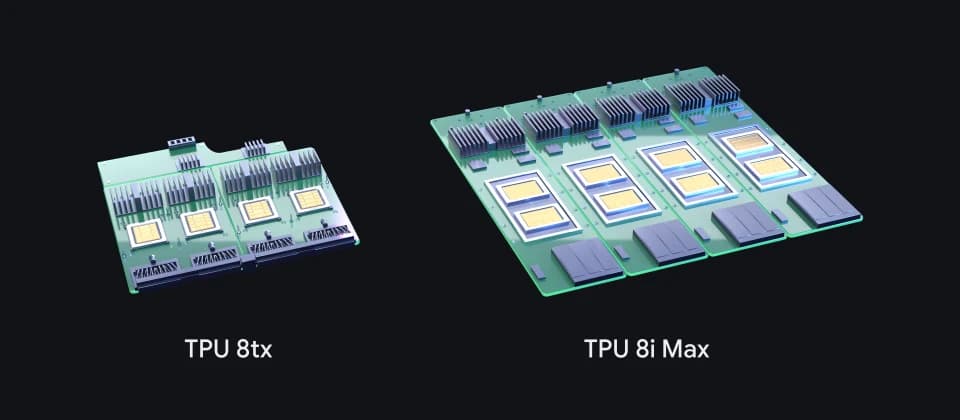
Google 發表兩款第八代 TPU 系統:TPU 8tx 主打機密運算,TPU 8i Max 則為大量 AI 代理同時處理長上下文而設。據 iThome 報道,兩者反映企業採用生成式 AI 時,關注點正由單一晶片算力,擴展至資料保護、記憶體容量、網絡傳輸及推論吞吐量。
受高度監管行業、持有敏感企業資料的用戶,以及需要保護模型權重的模型供應商,會是 8tx 的主要目標。至於需要同時閱讀大量檔案、文件和電郵,再由多個 AI 代理分工完成任務的工作負載,則是 8i Max 所瞄準的場景。
8tx 將保護範圍延伸至 CPU 與 TPU 之間
iThome 報道指出,TPU 8tx 建基於 TPU 8t,配合客製化 AMD CPU,並在硬件層加入機密運算機制。按 Google 的說法,資料由 CPU 經 PCIe 傳送至 TPU 的路徑,以及處理環節均會加密,目標是保護模型權重、prompt 與企業資料,減少系統操作人員窺探敏感內容的風險。
這個設計的意義,在於保護對象不只限於儲存中的資料,也涵蓋模型訓練及推論期間正在流動和運算的內容。iThome 又指出,Google 計劃容許特定企業把 8tx 部署至自有資料中心,讓機密運算不局限於公有雲環境。
不過,硬件層加密只是企業資料保護的一部分。報道未有交代金鑰管理、身分權限、應用程式存取控制及實際部署條件,因此企業仍須按自身合規要求評估整體安全架構。iThome 指出,8tx 同時引入 8i 的低延遲網絡拓撲,目標是在加入保護後仍維持較短的晶片通訊路徑。
8i Max 對準代理工作流的記憶體壓力
TPU 8i Max 把兩枚 8i 晶片整合在同一模組,系統級高頻寬 RAM 為 384GB,較 8i 多 33%;記憶體存取頻寬達每秒 17.2TB,SRAM 快取亦增至 768MB。這些改動主要為容納更多上下文資料與 KV cache,避免多個代理在長工作流程中反覆受制於資料搬移。
Google 透過 iThome 表示,8i Max 的重點是把整體吞吐量提升至兩倍,而非單純提高單一請求的速度。這項說法仍屬廠商主張,未見報道提供獨立測試;但從架構取向看,較大的記憶體與頻寬較適合大量併發、長上下文的推論工作。對企業而言,評估時應把實際模型、上下文長度、併發量及成本一併納入,而非只比較峰值數字。
軟件支援決定 TPU 是否容易採用
硬件之外,Google 亦正嘗試降低 TPU 的軟件遷移門檻。iThome 報道提到,Google 與 Meta 推出 TorchTPU 開源項目,為 PyTorch 提供原生 TPU 後端;Google 又為 vLLM 和 SGLang 推出 TPU 後端支援。過去 TPU 主要配合 JAX 與 TensorFlow,新增這些選項後,既有 PyTorch 工作流程,以及採用兩個開源推論引擎的團隊,理論上較易把工作負載移至 TPU。
實際影響在於,開發團隊未必需要由零重寫模型、函式庫和推論服務流程。不過,能否順利遷移仍取決於所用模型、算子支援、監控工具及部署流程;「改動數行設定」是 Google 的描述,並不等同所有工作負載都可無縫轉換。
iThome 報道沒有提供香港的售價、供應、可用區或本地客戶部署資訊。下一步值得觀察的是,Google 能否公布更具體的可用性與企業採用案例,以及 PyTorch、vLLM 和 SGLang 的 TPU 支援會否在實際生產環境中縮短遷移時間。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- iThome — 搶攻企業AI規模化的需求,Google新推兩款TPU新系統,TPU首度支援機密運算 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。