RTX Spark 筆電與 DGX Spark:同源核心下的記憶體取捨
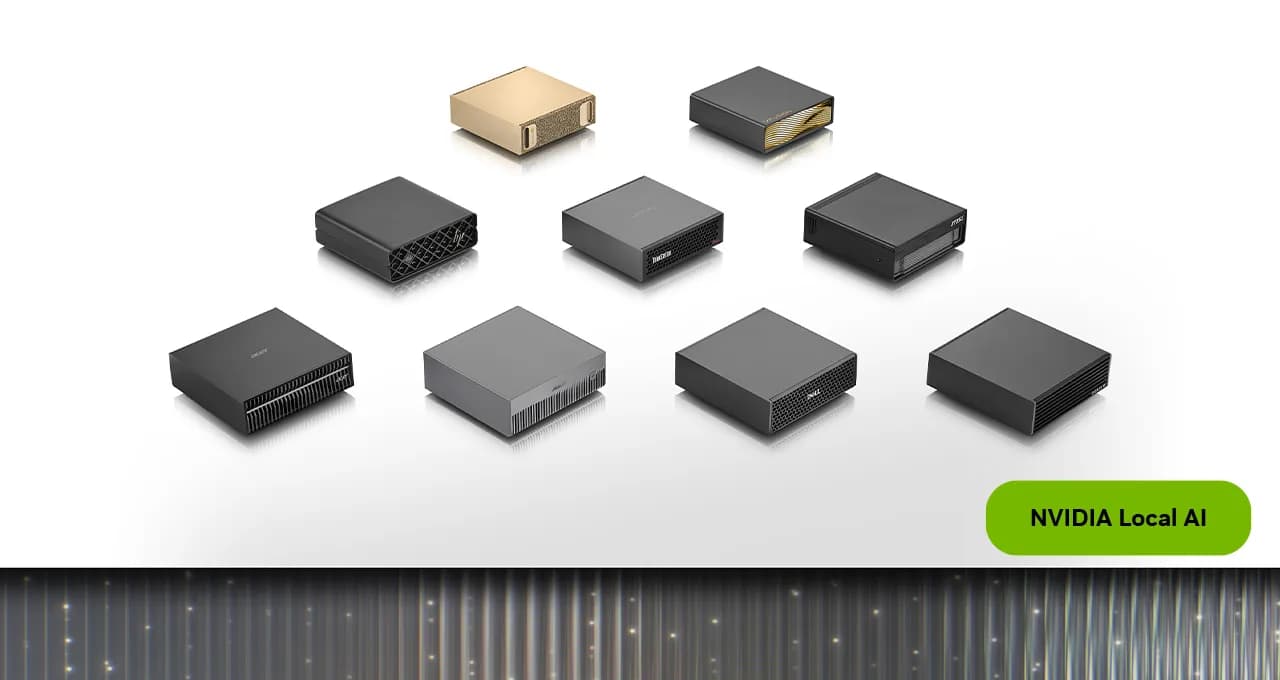
XDA Developers 以 HP OmniBook Ultra 16 的 RTX Spark 與 DGX Spark 作比較,發現兩者回報的 SoC、CPU 及 GPU 資訊高度一致,運算 benchmark 多數只相差一至兩個百分點。不過,這不等於兩款產品在實際工作流完全相同:筆電的記憶體頻寬較高,Windows 與 Linux 對統一記憶體的分配方式亦有明顯差異。
對打算在本機運行大型語言模型(LLM)或開發 CUDA 工作負載的人,重點不只在峰值算力。來源的結論建基於單一 HP 筆電及一部 DGX Spark 的測試;韌體、驅動程式、作業系統排程和功耗設定都可能影響結果,因此不宜直接套用至所有 RTX Spark 或 GB10 裝置。
似是同一設計,差別落在平台配置
XDA 指兩機回報相同的 SoC 修訂版本、10 個 Arm Cortex-X925 效能核心及 10 個 Cortex-A725 效率核心;GPU 亦回報相同的 48 個 SM、24MiB L2 cache 與最高 3,003MHz 時脈。驅動程式和韌體中的多項識別資料也相互吻合。
這些證據支持兩者採用高度相近、很可能同源的晶片設計,但 XDA 也未能確認不同產品型號有否在晶粒層面關閉部分功能。因此,較穩妥的理解是:硬件基礎非常接近,而產品差異主要由記憶體速度、韌體設定及作業系統帶來。
LLM 較受記憶體頻寬左右
兩部機器同為 128GB、256-bit LPDDR5X 統一記憶體,但 HP 筆電為 9,400MT/s,DGX Spark 為 8,533MT/s。XDA 的 GPU 讀取測試量得前者達 282.9GB/s,後者為 239.8GB/s,筆電領先約 18%,高於紙面頻寬差距。
這對逐 token 讀取模型權重的本機 LLM 特別重要。XDA 以量化後的 Qwen 3.8 Flash Next 配合 llama.cpp 測試,估算 RTX Spark 的實測頻寬可對應約每秒 58 token 的理論上限,DGX Spark 約為 49;該 HP 筆電實際約達每秒 45 token。這是特定模型、量化方式及軟件設定下的結果,不能視作所有模型的通用表現,但反映頻寬往往比純運算峰值更能限制推理速度。
相反,兩者的 FP16、FP8、INT8 與 FP32 運算測試相當接近。換言之,若工作負載主要受運算單元限制,兩者未必有顯著距離;若經常搬運大量模型權重,較快記憶體的筆電可能較有優勢。
Windows 的預留模式,Linux 的彈性分配
同樣是 CPU 與 GPU 共用的統一記憶體,兩套平台採取不同策略。XDA 指 Linux 上的 DGX Spark 可讓 CUDA 視乎需要使用整個記憶體池;Windows 的 RTX Spark 則可預留最多 96GB 作「專用」GPU 記憶體。其測試把專用 GPU 記憶體設為 84.5GB 時,Windows 剩下約 41GB 系統記憶體可用。
這個分別直接影響開發取捨。Windows 的主機與裝置記憶體複製,在測試中超過 Linux 一倍;但 Linux 可讓 GPU 讀取一般由 CPU 配置、未先註冊的記憶體,Windows 則不支援該模式。Linux 的 CUDA managed memory 測試也較快,而 Nvidia 的 RTX Spark 移植指引建議開發者在 Windows 避免使用 managed memory,原因正是兼容路徑的效能成本。
對偏向 Windows 筆電環境、重視日常使用與直接跑本機模型的用戶,RTX Spark 的較高頻寬和記憶體預留方式有其吸引力;但需要沿用 Linux/CUDA 的統一記憶體工作流、或依賴相關記憶體存取能力的開發者,DGX Spark 的模式仍較貼近原生開發環境。
下一步值得留意的是,不同廠商的 RTX Spark 產品會否沿用相同記憶體速度與韌體設定,以及軟件工具能否把 Windows 與 Linux 的共享記憶體差異處理得更透明。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理,並經兩輪獨立自動品質審核;資料及連結仍以原始來源為準。
參考來源
- XDA Developers — Nvidia's RTX Spark laptops use the same chip as the DGX Spark, but they get faster memory and features the DGX Spark doesn't — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。