把公司文件交給 AI:Bedrock Knowledge Bases 與 RAG 入門
AWS re:Invent 2026・TechLab 出發前系列
公司已有一大堆產品文件、內部指引與常見問題,為甚麼 AI 回答時仍可能用錯規則?問題未必只在模型,也可能在它拿到的是哪一份資料。re:Invent 預熱這一篇,從 Bedrock Knowledge Bases 說明 RAG 的用途,以及導入前應整理的文件工作。
先找資料,再讓模型回答
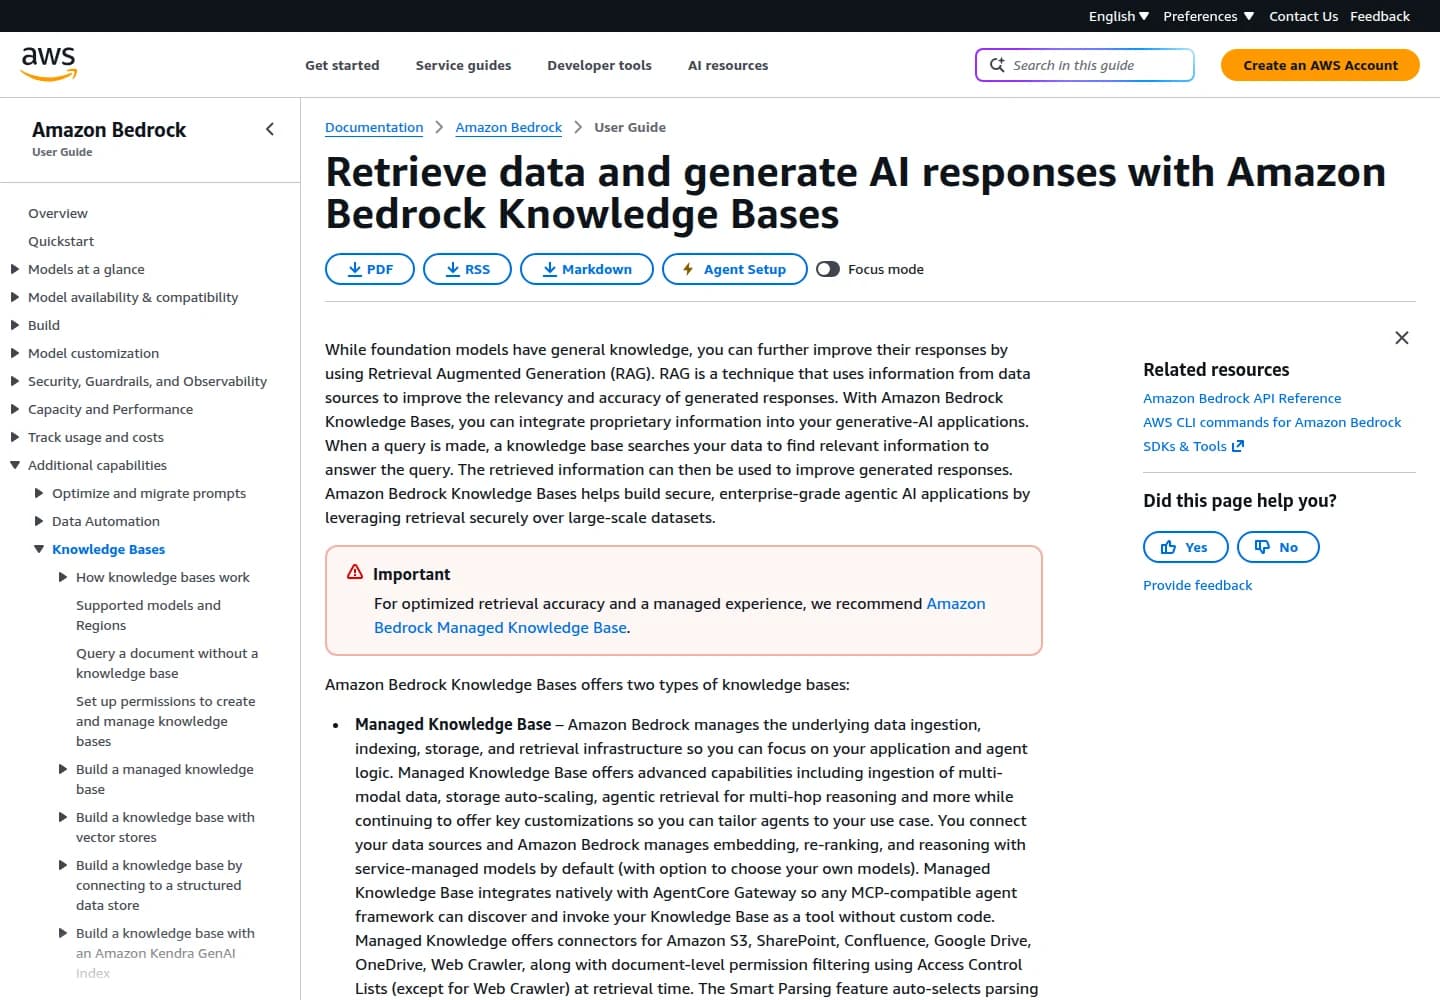
按 AWS Knowledge Bases 文件,RAG 會從資料來源找出與問題相關的內容,用來輔助生成回答。Knowledge Bases 可把企業資料接入生成式 AI app,亦可在回答中附上引用,方便查閱原始出處。
用一個假設例子理解:同事詢問某產品的退款條件,系統先搜尋相關政策,再把找到的內容交給模型整理。這跟單靠模型原有知識回答不同;但若搜尋到過期版本,語句再流暢,也可能把舊規則說得頭頭是道。
文件整理,是搜尋品質的一部分
開始前可以先挑一個範圍清楚的資料集,例如單一產品的公開支援文件。為每份文件記下適用產品、版本、生效日期與負責維護的人,並把已失效內容明確分開。這是編輯建議的準備方法,並非 AWS 規定的唯一格式。
尤其要留意標題相同、適用對象卻不同的文件。例如一般退款政策與促銷活動的例外條款,都可能提到同一產品。若只問系統「能否搜尋 PDF」,仍未觸及實際使用中最容易出錯的地方:它能否辨認適用條件,以及保留例外說明。
有引用,還要看引用支持甚麼
來源連結是核對答案的入口。讀者仍應打開被引用的段落,看看它是否支持回答中的結論,尤其是日期、數量與限制條件。引用提到「可申請」時,回答若變成「一定獲批」,兩者意思便不同。
驗證可以拆成兩次:先看系統取回的文件是否相關,再看生成的答案有沒有忠實使用那些內容。假如第一步已找錯資料,只改寫 prompt 未必能解決根本問題;若資料正確但結論加了原文沒有的保證,則要集中檢查生成部分。
文件權限不能一概而論
目前 AWS 文件把 Knowledge Bases 分為 Managed 與 Customer-managed 兩類,並指出部分連接器、文件層級權限及整合能力只適用於 Managed 版本。選擇時要看具體方案,不能把其中一種的功能直接套用到另一種。
團隊可以先列出不同同事應看到的資料,再用測試帳戶驗證。例如一般客服與主管是否能存取同一批文件,文件刪除或權限改動後,又應如何確認搜尋結果已更新。這些是部署驗收項目,不是單靠「企業級」標籤就能略過的工作。
用一小組問題找出真正缺口
開始時不妨準備幾類問題:答案就在單一文件內、需要合併兩份資料、文件之間有衝突,以及資料集根本沒有答案。每次測試保留取回內容與最後回覆,會更容易辨認問題發生在哪一步。
到了 re:Invent,若新功能聲稱改善企業資料搜尋,可以用同一組問題追問它解決了甚麼:是更容易匯入資料、找到更合適的段落,還是更清楚處理權限?能把改進對應到自己的資料問題,才較容易判斷是否值得投入。
延伸閱讀:TechLab 出發前的三條觀察主線。
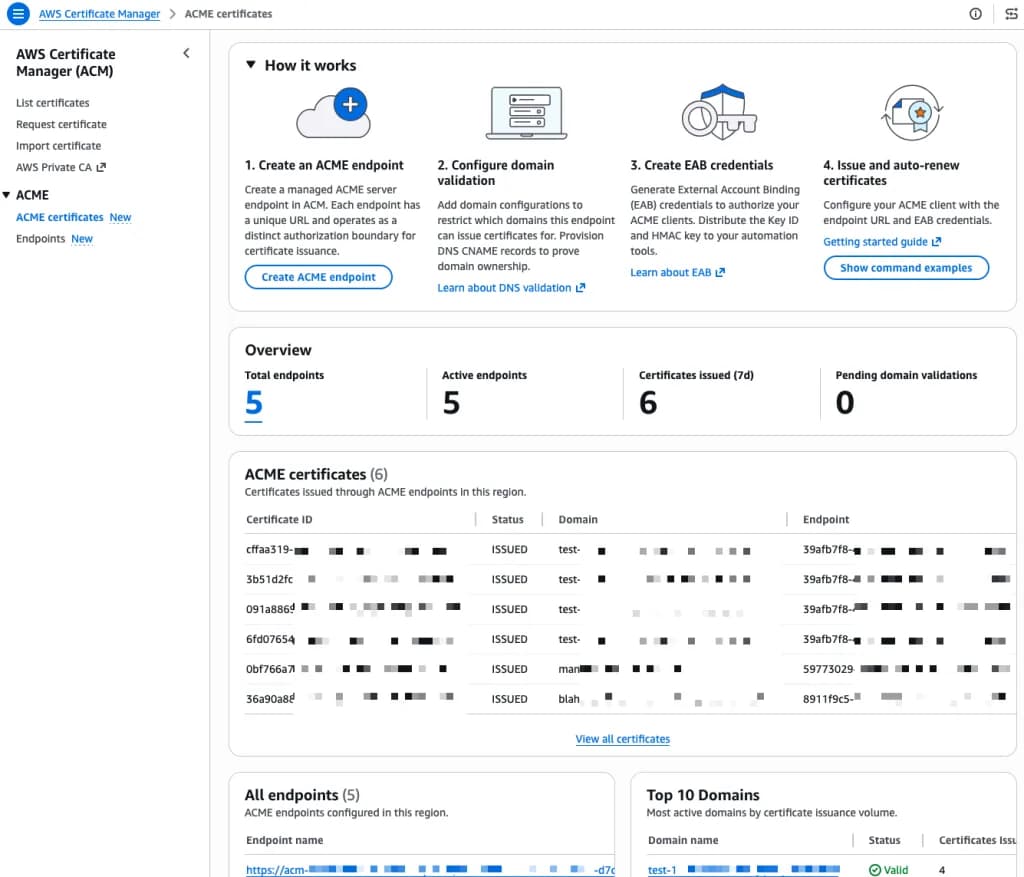
本文由 AI 輔助整理及撰寫,依據文內連結的公開資料。封面為官方頁面截圖,擷取於 2026 年 11 月 19 日(香港時間)。