從模型權重辨識 GPU:Blackwell 指紋研究的證據與界限
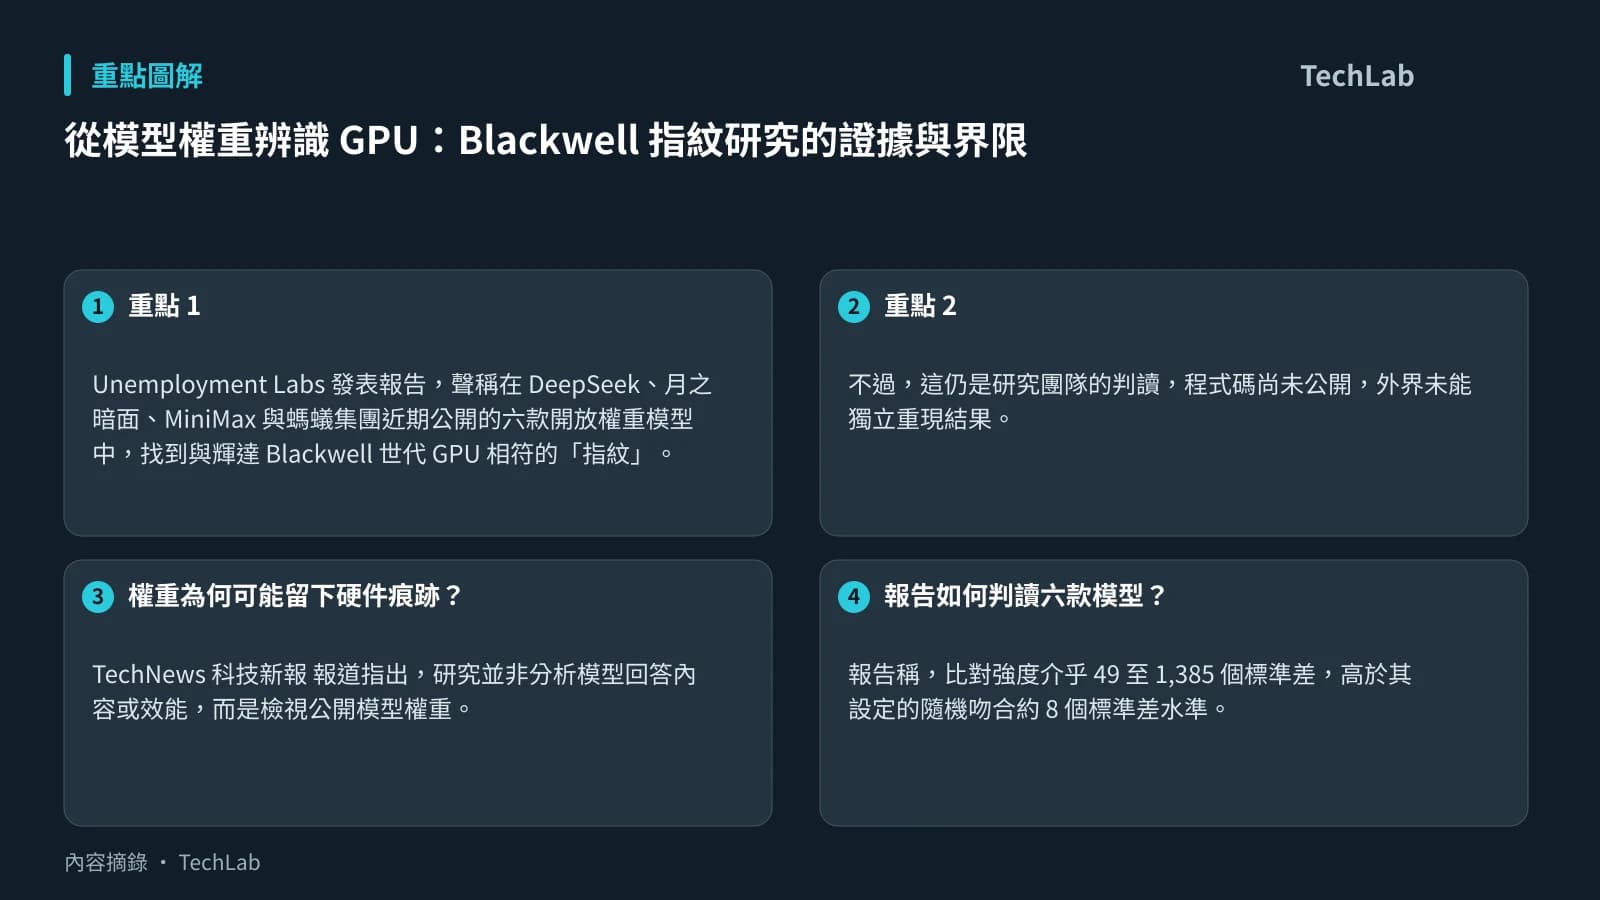
Unemployment Labs 發表報告,聲稱在 DeepSeek、月之暗面、MiniMax 與螞蟻集團近期公開的六款開放權重模型中,找到與輝達 Blackwell 世代 GPU 相符的「指紋」。若方法成立,模型權重或可成為追查訓練硬件世代的鑑識材料。
不過,這仍是研究團隊的判讀,程式碼尚未公開,外界未能獨立重現結果。更關鍵的是,這種指紋最多指向初始化階段可能使用的晶片世代,不能證實晶片所在地、取得途徑,或整個訓練流程均由 Blackwell 完成。因此,不能直接把結果延伸為規避出口管制已獲證實。
權重為何可能留下硬件痕跡?
TechNews 科技新報 報道指出,研究並非分析模型回答內容或效能,而是檢視公開模型權重。在 PyTorch 初始化權重時,輝達 cuRAND 函式庫會使用 Philox 偽隨機數產生器,把運算分配至 GPU 執行緒;不同 GPU 的串流多處理器(SM)數量不同,即使使用相同種子值,產生的數值在權重中的位置也會不同。
研究團隊的思路是:部分在訓練後幾乎未被改動的權重,仍可能保存初始化時的數值排列。團隊搜尋約 6 兆組種子值與執行緒數組合,再把結果與不同硬件的預期模式比較,找出最吻合者。這屬於從訓練產物反推運算環境的模型鑑識,而非直接讀取訓練日誌。
報告如何判讀六款模型?
按 TechNews 科技新報 報道所述,DeepSeek-V4-Flash 與 MiniMax-M3 的比對結果符合 B200/B300;DeepSeek-V4-Pro、Kimi K3、K3.1-Pro,以及螞蟻集團 Ling-3.1-flash,則符合 GB200/GB300 系統。報告稱,比對強度介乎 49 至 1,385 個標準差,高於其設定的隨機吻合約 8 個標準差水準。
團隊亦表示,這套方法曾正確判讀 24 款已公開訓練硬件的模型,並在實體 Blackwell 晶片重現部分結果;同批業者較早期模型則被判讀為 Hopper 架構。這些資料支持方法值得檢驗,但仍主要來自研究團隊本身,未等同獨立驗證。
證據可說明甚麼,不能說明甚麼
此類分析的價值,在於它可能讓公開權重增添可審核的技術線索,令外界能就模型訓練硬件提出更具體的問題。對研究者、雲端供應商與政策制定者而言,若日後工具與資料公開,便有機會比較不同模型、框架及硬件配置下,這類痕跡是否穩定可靠。
但證據範圍也需要嚴格劃清。初始化使用某一世代 GPU,不代表後續全部訓練都使用同類硬件;指紋也無法辨識晶片在哪個地點運作、由誰持有,或是透過何種方式取得。TechNews 科技新報 指出,使用美國雲端服務租用晶片也是可能情況,而美國國會正審議的《雲端安全法》正試圖處理相關監管缺口。
下一步值得觀察的是 Unemployment Labs 是否公開程式碼與完整驗證材料,以及其他研究者能否以不同模型與已知硬件環境重現結果。在此之前,這份報告較適合被視為一項有待交叉檢驗的模型鑑識主張,而非對任何採購或出口管制行為的定論。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- TechNews 科技新報 — 研究找到 DeepSeek、Kimi 等六款中國 AI 模型以受管制輝達 Blackwell 晶片訓練痕跡 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。