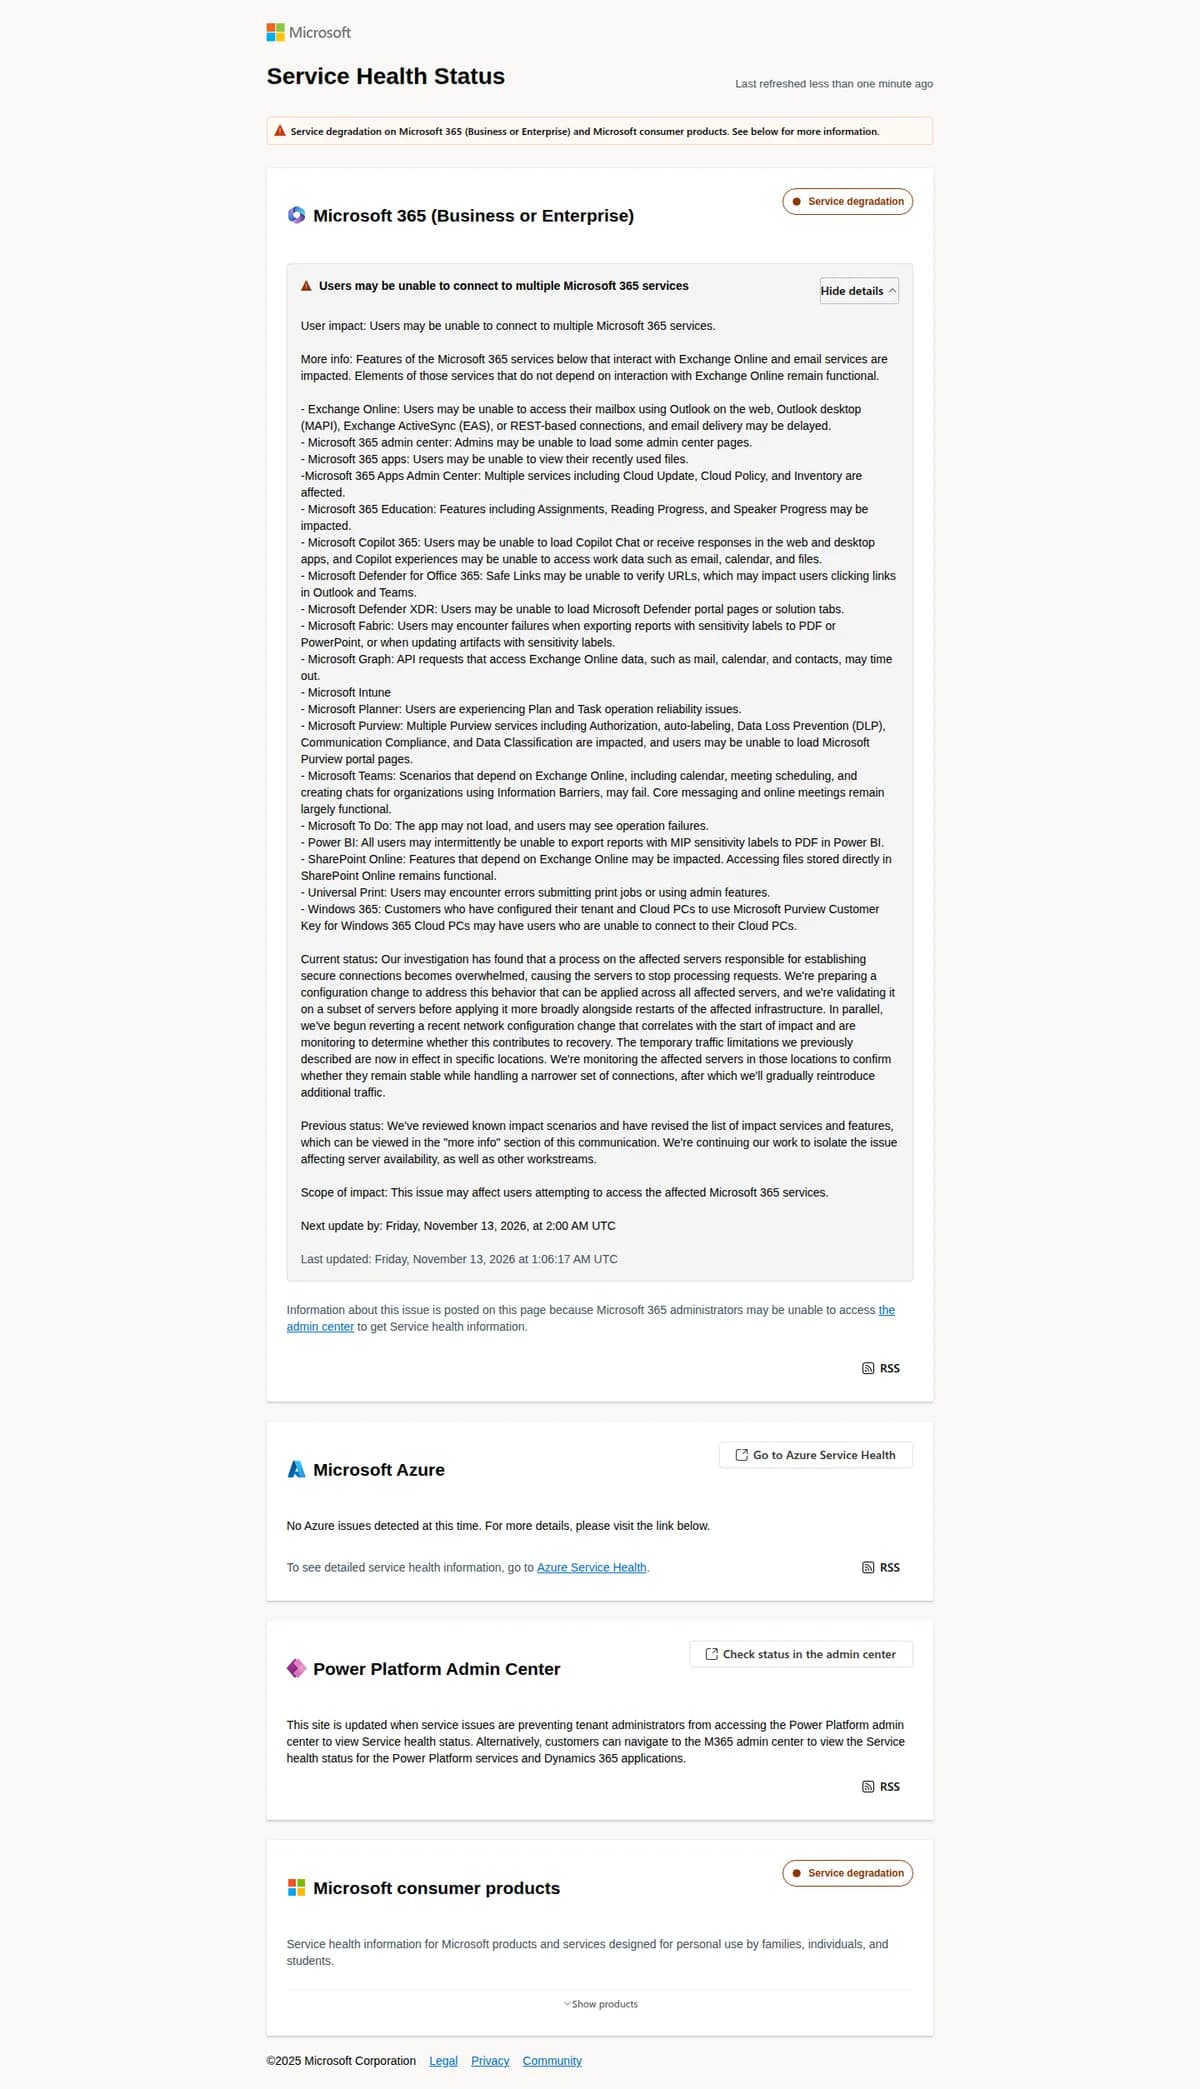
Microsoft 大規模故障揭三項連鎖成因
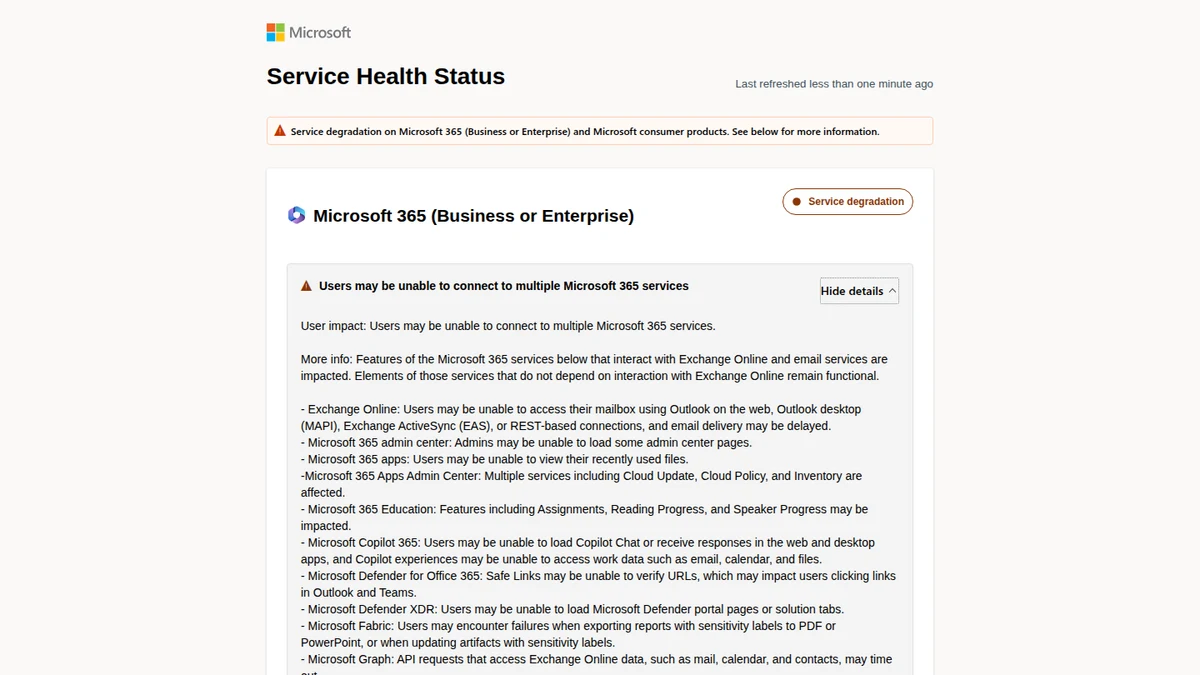
Microsoft 公布初步事故報告,交代此前令 Outlook、Teams、Copilot 365 等服務離線的大規模故障。事件波及全球企業、醫院、執法部門及其他機構,持續接近一整天;不過,最終技術細節仍要等待 Microsoft 本週稍後發布的完整報告。
這宗事故的重點在於,並非單一元件失靈便立即造成全線中斷。Microsoft Copilot 與 AI Agents 執行副總裁 Charles Lamanna 表示,三個條件在同一時間疊加,令原本的故障演變成服務層面的連鎖問題。
三項因素如何連鎖
Microsoft 平時以兩套網絡閘道系統連接不同系統、傳送資料。此次其中一套閘道未能為 Teams 正常運作,流量因而湧向主要閘道。與此同時,該主要閘道約 14% 容量正因前一天一宗無關事故而無法使用。
在流量增加及可用容量減少之下,系統觸發了一個自 7 月已存在的潛伏 bug。請求不斷累積,最終令 Microsoft 系統停止運作。事故發生於美國使用高峰時段的星期四下午,放大了負載壓力。
修復也受到同一個流量問題牽制。Microsoft 雖然通宵處理,但該 bug 已存在數月,無法單靠回復舊版本迅速排除;服務重啟後,大量等待處理的流量又一度令系統失去回應。
對用戶與 IT 團隊的提示
從初步說明看,備援設計即使存在,也可能在容量受損與流量轉移同時發生時成為瓶頸。這是根據 Microsoft 已披露的事故條件作出的分析,並非最終根因結論。
圖片:Microsoft
對一般用戶而言,遇到 Teams、Outlook 或其他雲端工作流程異常時,可先比對 Microsoft 的官方服務狀態公告與機構內部通知,避免把平台範圍的故障誤判為個人帳戶、網絡或裝置問題。對 IT 團隊而言,則應在事件期間分別驗證登入、訊息、郵件與關鍵工作流程,而非只看到單一功能恢復便判定整體服務正常。
較依賴 Microsoft 雲端服務的機構,也可預先界定通訊與檔案協作的替代流程、緊急聯絡名單,以及何時切換至備援安排。這些措施不能消除供應商故障,但有助於在服務反覆恢復與失效時維持關鍵運作。
下一個值得留意的是 Microsoft 的最終事故報告:它將說明這個潛伏 bug 的具體性質,以及公司會否調整閘道容量、流量處理或復原程序。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- Engadget — Microsoft reveals that an old bug caused the massive outage that took its services offline — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。