Microsoft 365 當機初查:三重壓力如何引發閘道連鎖故障
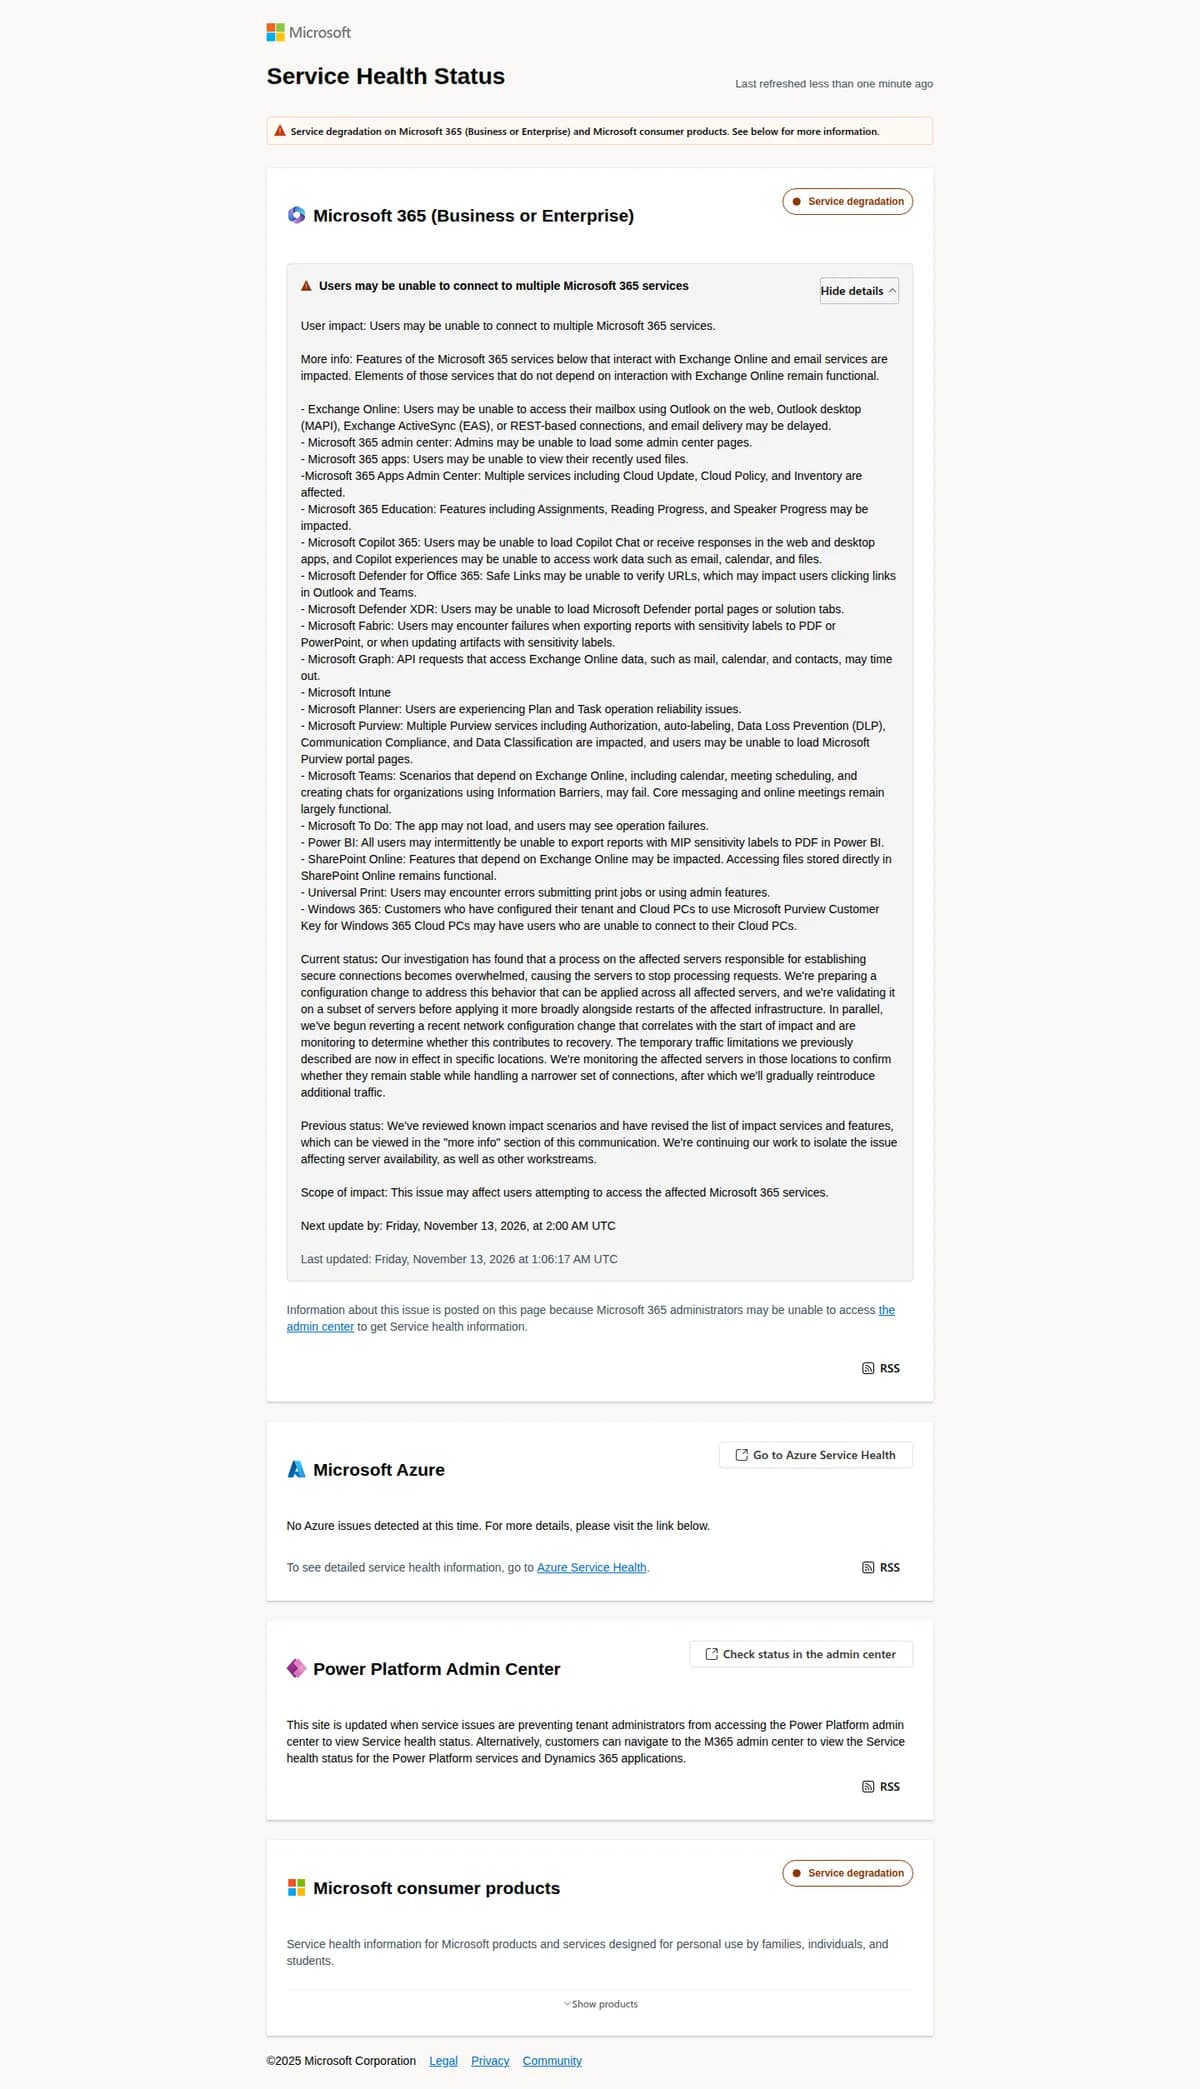
Microsoft 365 在美東時間 11 月 12 日發生全球服務異常,持續逾 30 小時。iThome 報道指出,微軟的初步調查把事故指向一項已潛伏超過三個月的程式缺陷;它並非單獨造成中斷,而是在流量模式改變與可用閘道容量減少時,一同觸發大規模連鎖故障。
受影響服務包括 Exchange Online、Teams、OneDrive、SharePoint 及 Office app。不過,這仍是微軟公布的初步結果,完整事故檢討報告預計本週稍後才會發表;各機構實際受影響範圍與復原狀況,仍應以其 Microsoft 365 管理中心的 Service Health 資訊核實。
三項條件在短時間內疊加
微軟為 Microsoft 365 設有兩套相互獨立、架構不同的網路閘道,原意是在其中一套出現問題時維持服務可用性。iThome 報道指出,事故的起點可追溯至今年 7 月部署的一項閘道修正程式。該程式引入鎖定競爭(Lock Contention)缺陷,特定負載下會令伺服器停止回應。
測試未能抓到問題,與測試硬件配置有關:測試主要採用核心數較少、效能較低的機器,而缺陷更容易在新型多核心伺服器上出現。這使問題在部署後長時間未被察覺。
到事故前約 15 小時,Teams 從另一套獨立閘道轉用同時支援 Exchange Online 的主要閘道,令該處負載增加、流量模式改變。與此同時,約 14% 的閘道伺服器容量因前一天的其他問題暫停服務。當有缺陷的程式、額外流量及較少容量碰在一起,請求開始大量堆積。
系統原本會自動把流量導向仍正常的伺服器,但在這次事件中,轉移流量進一步壓垮剩餘節點;不到兩小時便形成連鎖故障。最嚴重時,超過 80% 網路閘道伺服器無法回應,分區隔離機制亦未能阻止問題擴散至全球。
為何 Exchange Online 復原較慢
Teams、OneDrive、SharePoint 與 Office app 能改經另一套閘道,因此較早恢復。Exchange Online 使用主要閘道,沒有相同的切換能力,因而停留在受影響路徑的時間較長。
修復過程也反映了這類基礎設施事故的困難:微軟初期未掌握根因,嘗試重啟伺服器時,大量積壓請求再度湧入,重新觸發缺陷。待工程師確認問題後,因缺陷早於 7 月部署,無法靠一般版本回復機制迅速處理,只能另行開發修正程式、分批修復與重啟伺服器。
圖片:Microsoft
用戶與企業可先準備甚麼
對使用 Microsoft 365 的企業、學校及機構而言,這次事件顯示「服務顯示已恢復」不一定代表所有工作流程同步正常。Exchange Online 若受阻,Outlook 收發電郵、Teams 行事曆與會議安排都可能間接受影響。
管理員可在事故期間透過官方 Service Health 查看租戶層級狀態與追蹤編號,並保留重要通知及異常時間紀錄。企業亦可預先訂下替代通訊方式,例如緊急聯絡電話、另一個訊息平台或外部電郵聯絡名單,避免單一雲端入口失效時,內外溝通同時中斷。
下一步應觀察微軟完整事故檢討報告會否交代測試覆蓋、多核心硬件差異、閘道隔離失效及 Exchange Online 備援設計的改善措施。這些資訊將比單次復原時間,更能說明同類事故能否減少重演。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- iThome — 微軟揭露Microsoft 365全球當機原因,潛伏3個月的程式錯誤釀禍 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。