以 iGPU 跑本地視覺模型,為獨顯留出家用 server 資源
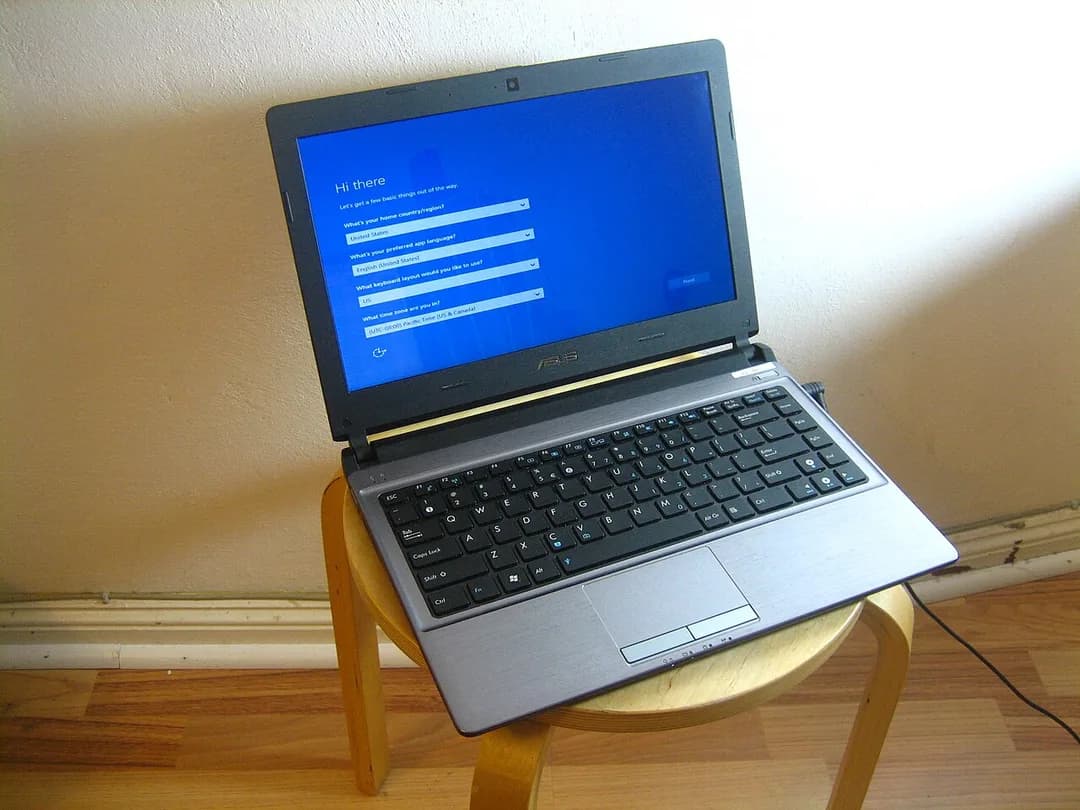
XDA Developers 一名作者把舊 Acer Nitro 5 改作家用 server,將 Liquid AI 的 LFM3-VL-2B 小型視覺語言模型放在 Intel UHD 內顯上執行,並刻意不佔用機內的 RTX 3050 Ti 獨顯。後者原本負責 Jellyfin 影片轉碼、Sunshine 遊戲串流等較吃 GPU 的工作;模型則透過區網供家人的手機及手提電腦使用。
這個案例的重點不在於以舊硬件追求 AI 效能,而是把有限的運算資源拆分使用。它同時說明,本地模型可為不希望上傳至 Gemini、ChatGPT 等雲端服務的銀行結單、醫療報告或保險文件,提供一個較受控的處理途徑;但它並不適合取代一般雲端聊天機械人,更不能假定本地運行便自然沒有私隱或保安風險。
把 iGPU 當成常駐的文件助手
作者使用 llama.cpp 的 Vulkan 版本,指定由 Intel 內顯處理模型,並以 nvidia-smi 監察,確認 llama.cpp 沒有使用 RTX 獨顯。LFM3-VL-2B 屬於視覺語言模型,能看圖像及文件截圖,正好配合「解釋文件內容」這類工作。報道也提到,使用該模型需要 llama.cpp build 11960 或以上。
這種分工對已有獨顯、而獨顯同時要負擔轉碼、串流或其他 GPU 工作的家用 server 用戶有實際意義。小模型放在 iGPU 背景運行,意味著不用為一項偶發的文件問答服務長期佔用獨顯。至於沒有獨顯的電腦,這種做法仍可嘗試,但效能限制會更直接地落在使用體驗上。
慢速與能力限制,決定了適用範圍
作者的實測顯示,向模型輸入一份兩頁的掃描租約並提問,模型處理約 7,098 個輸入 token,約 3 分 33 秒才輸出第一個 token,完整回答約需 4 分 14 秒;生成速度約為每秒 6.11 個 token。這足以處理偶爾需要摘要的文件,卻難以支持即時對話式使用。
此外,報道指 LFM3-VL-2B 未能直接處理 PDF,使用者要先把文件截圖再上傳,增加了一個步驟。作者亦坦言,這個 20 億參數模型的推理能力無法與 ChatGPT 或 Gemini 相提並論,較適合提取大意、協助閱讀,而非處理需要細緻推論或高度準確性的問題。涉及醫療、財務或保險內容時,模型輸出仍應由使用者核對原始文件及專業意見。
私隱優勢取決於整套環境
在同一個受控區網內提供服務,確實可減少把敏感文件交由第三方雲端處理的需要;這正是作者採用本地模型的主要原因。不過,這是部署方式帶來的取捨,不是任何本地模型都自動具備的保證。裝置本身、區網存取權限、上傳檔案如何保存,以及模型 server 是否對外開放,都會影響最終的資料風險。
因此,這類配置較適合把「本地保留」放在優先位置、可接受數分鐘等待時間,且能自行管理家用網絡與設備的人。接下來值得觀察的是,小型視覺模型能否改善 PDF 讀取與文件理解,同時維持可由 iGPU 承擔的資源需求;那會決定這種家用文件助手能否從小眾實驗走向更實用的工具。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- XDA Developers — I run a small local model on my laptop's integrated graphics, so my dedicated GPU stays free for other work — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。