GitHub Rubicon拆開Git寫入路徑,為AI代理併發開發鋪路
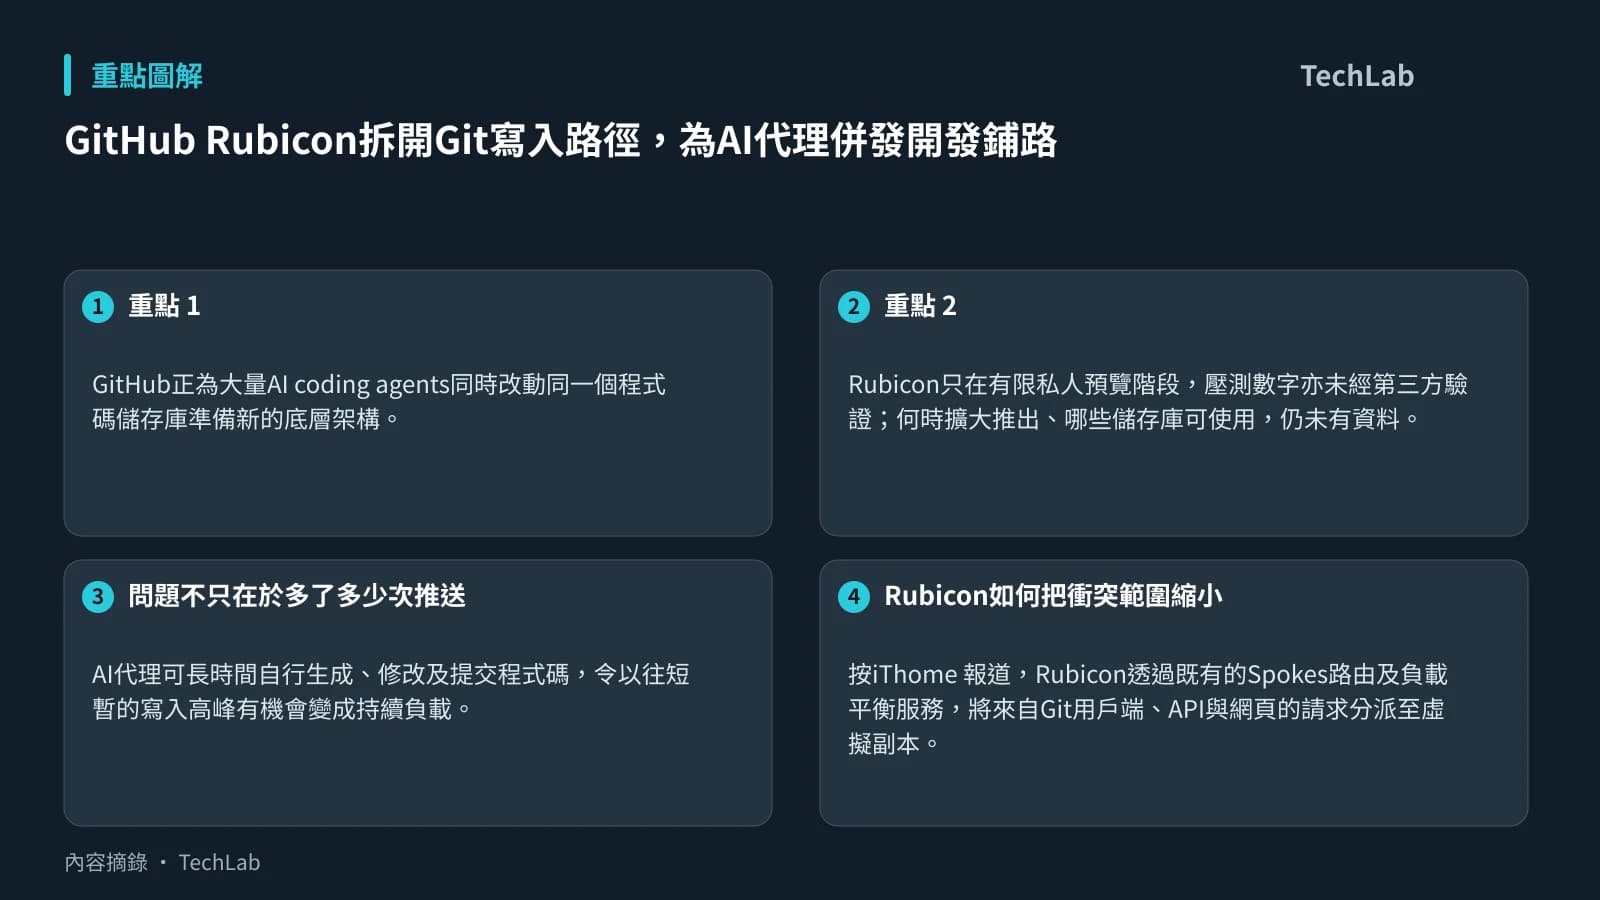
GitHub正為大量AI coding agents同時改動同一個程式碼儲存庫準備新的底層架構。iThome 報道指出,GitHub推出名為 Rubicon 的Git儲存架構,將儲存、讀寫處理與分支參照更新分拆;官方內部壓測稱,單一儲存庫可讓5,000個代理同時工作,並每秒接收7,200次推送。
這並非一般開發者現時即可啟用的Git功能。Rubicon只在有限私人預覽階段,壓測數字亦未經第三方驗證;何時擴大推出、哪些儲存庫可使用,仍未有資料。
問題不只在於多了多少次推送
AI代理可長時間自行生成、修改及提交程式碼,令以往短暫的寫入高峰有機會變成持續負載。iThome 報道引述GitHub的觀察:一個高流量儲存庫的每日平均請求量,曾由3月約4,400萬次升至5月約1.81億次。一次推送又可能觸發持續整合、部署及其他代理讀取,壓力會沿開發流程擴散。
傳統上,儲存庫內的寫入操作容易因共享狀態而互相等待。當大量代理各自處理不同工作項目時,真正的瓶頸未必是產生程式碼,而是如何安全地把多項更新寫回同一個儲存庫,同時維持讀取速度與資料一致性。
Rubicon如何把衝突範圍縮小
按iThome 報道,Rubicon透過既有的Spokes路由及負載平衡服務,將來自Git用戶端、API與網頁的請求分派至虛擬副本。這些副本只保存可重建的快取;Git物件則以Packfile形式放在Azure Blob Storage。
較關鍵的改動是,分支等參照資料交由Ref-CAS管理。它以比較並交換機制處理更新,交易只鎖定相關參照,而非把整個儲存庫的寫入串行化。虛擬副本會先保存Packfile,再提交參照更新,減低分支指向未儲存資料的風險。
從架構設計推論,若多個代理分別更新不同分支,它們可更大程度並行完成提交;但若它們競逐同一分支或同一參照,仍需要處理更新衝突。換言之,Rubicon改善的是儲存庫層面的併發能力,並不會自動解決代理之間的程式碼審核、合併策略或任務分工問題。
GitHub亦把Packfile整理與垃圾回收移至獨立節點,避免維護工作佔用處理讀寫請求的資源。iThome 報道指,官方內部測試顯示,寫入量增加時讀寫延遲仍維持平穩,但這項結果仍有待真實、大規模工作負載驗證。
哪些團隊較值得留意
對少量開發者、低頻提交的專案來說,這次改動短期未必改變日常Git操作。較可能受惠的是同時運行多個代理、頻繁建立分支與自動提交的團隊,以及需要讓CI、部署流程和代理持續讀取同一儲存庫的工作流程。
下一步要觀察的,是GitHub會否公開預覽範圍、真實環境下的延遲與可靠性數據,以及這種高併發儲存庫能力能否配合更成熟的代理協作及管治工具。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- iThome — GitHub重構Git底層儲存架構,單一儲存庫壓測每秒可接收7,200次推送 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。