Databricks 推 AI Runtime,將表格基礎模型接入企業 GPU 工作流
Databricks 發表 AI Runtime,將表格基礎模型(Tabular Foundation Model,TFM)放進全代管的無伺服器 GPU 運算環境。目標客戶是依賴表格資料作預測的企業,例如信用風險、客戶流失、需求預測及預測式維護團隊。
這項產品的核心承諾,是減少每新增一個預測任務,便要另行開發、訓練與維護模型的工作。不過,平台的效能、可擴展性及實際準確度目前主要來自廠商說法,仍需由不同資料集與真實企業工作負載作獨立驗證。
把已標記資料變成推論脈絡
iThome 報道指出,TFM 會先以大量不同的合成表格資料集預訓練,嘗試掌握欄位與變項之間的關係。實際預測時,使用者會把已有標籤的資料列,連同待預測的資料列一併輸入模型;模型透過注意力機制比對兩者,經一次前向式運算輸出結果。
這種情境學習方式的意義,在於團隊可先以現有標記資料啟動預測,而不必把每個新資料集都視為一個從零訓練的專案。對資料科學人力有限、但預測需求分散的企業而言,模型建立與維護的門檻有機會下降。
但「免客製化訓練」不等同所有任務都毋須調整。iThome 指出,TFM 仍可針對特定資料集微調預訓練權重,以提升準確性。這意味著高要求的應用,仍可能需要資料準備、驗證及模型調校;平台改變的是預設起點與工作流程,而非消除預測模型的品質責任。
圖片:Databricks
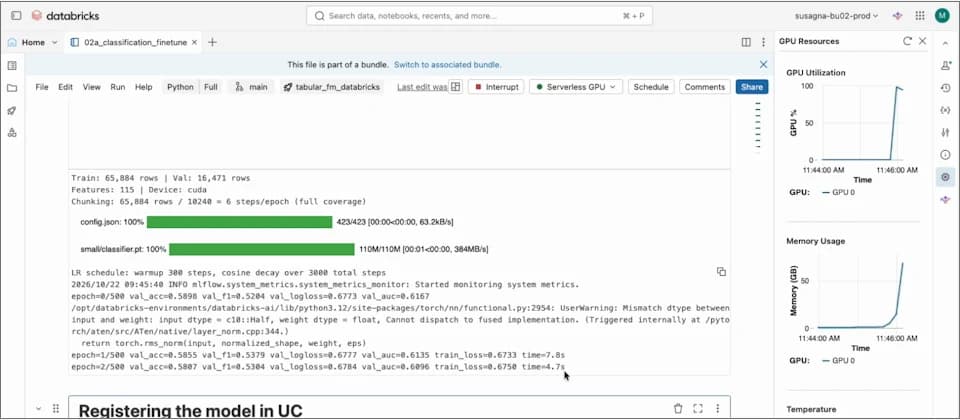
GPU 環境、開發工具與部署放在同一平台
AI Runtime 將 TFM 的推論與訓練需求,放到 Databricks 的 GPU 工作流中。iThome 報道稱,平台提供 GPU 資源、深度學習堆疊、GPU 利用率觀測,以及 MLflow 實驗追蹤;並原生支援 notebooks、Lakeflow Jobs、Unity Catalog 和 Docker,也可透過 Databricks CLI 遠端 SSH 存取。
對開發團隊來說,這些整合的實際價值在於減少在模型實驗、排程、資產治理與生產環境之間切換工具的成本。Lakeflow Jobs 可處理工作流程的自動化、排程與監控;Unity Catalog 則用於集中管理資料、分析及 AI 資產。若企業原本已在 Databricks 平台管理資料,接入 TFM 的流程理論上會較直接。
平台亦提供名為 Genie Code 的代理人。據 iThome 報道,它針對深度學習及 GPU 工作,協助撰寫與除錯推論、訓練程式碼,並處理瓶頸及框架錯誤。這可望降低部分 GPU 開發的操作負擔,但程式碼正確性、模型選擇與資料品質,仍需要開發與資料團隊審核。
REST 端點讓預測進入 app
在部署一端,AI Runtime 可透過 Databricks Model Serving,把 TFM 變成 REST 端點。這讓信用評分、產品推薦等需要即時回應的 app,能以 API 呼叫模型預測結果。
Databricks 表示,平台可彈性存取 GPU,並支援以 H100 執行 TabPFN-3、處理最高 100 萬列與 200 萬個特徵的工作負載。這類規模描述反映其瞄準大型表格資料場景,但各企業的延遲、成本與準確度,仍會受到資料形態、標籤品質及實際部署設定影響。
Databricks 已發布技術指南與開源程式碼範例。下一步值得觀察的是,企業會否將 TFM 用於既有預測流程,以及在微調需求、GPU 成本與模型治理之間,能否取得足以取代傳統逐案建模的平衡。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- iThome — Databricks發表表格基礎模型運算平臺AI Runtime — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。