Arete-27B 的意義:用 5,000 萬 token 重塑開源模型回答
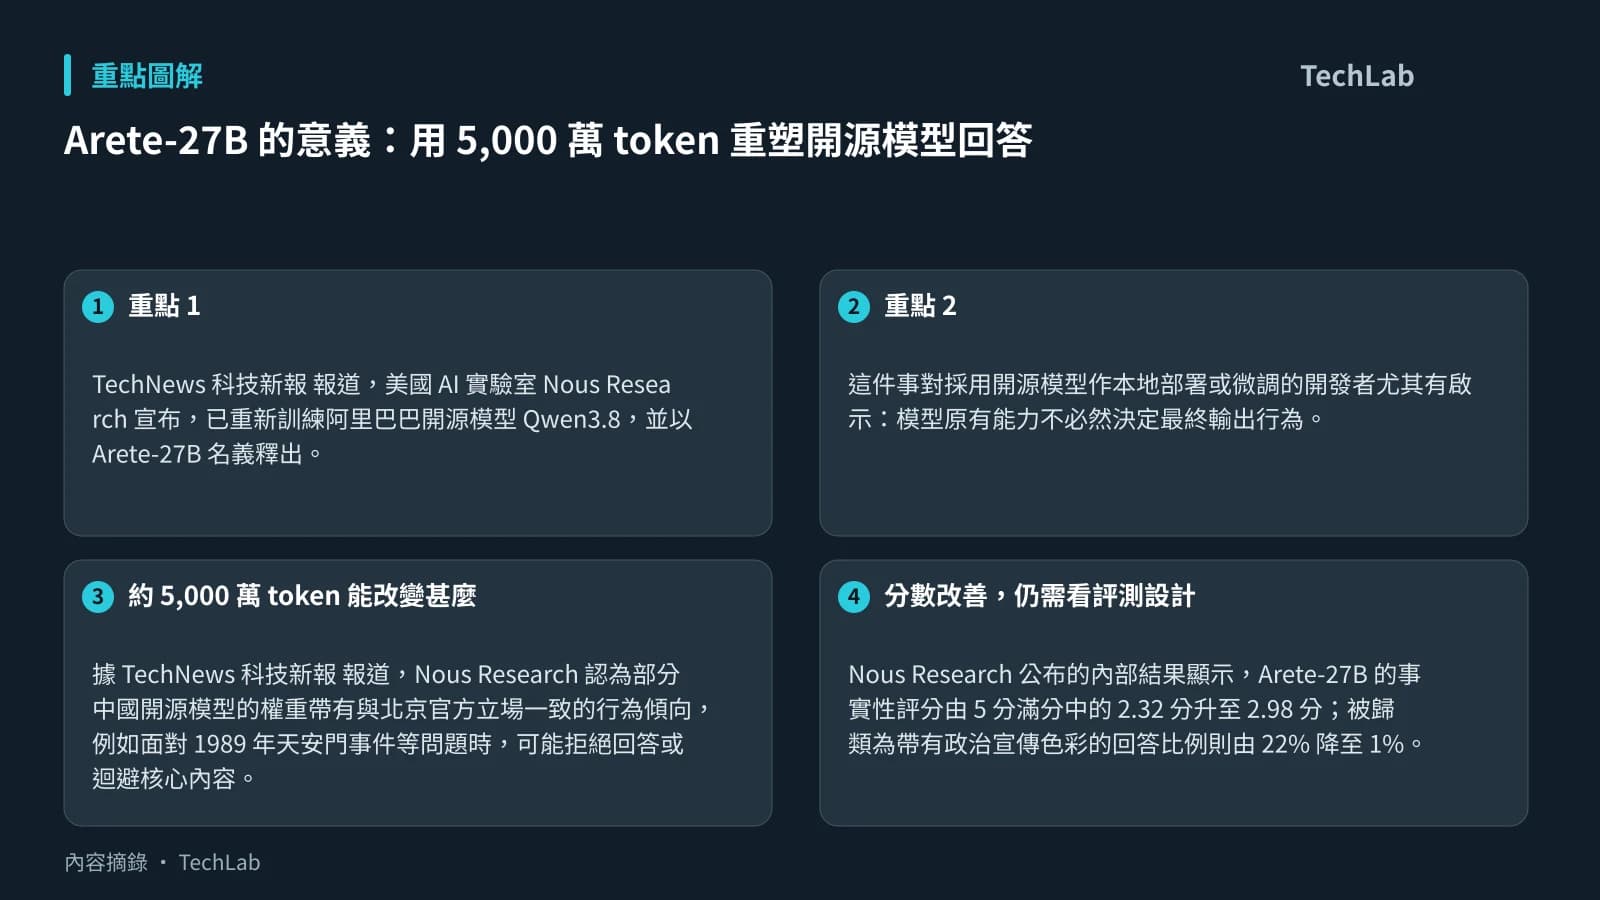
TechNews 科技新報 報道,美國 AI 實驗室 Nous Research 宣布,已重新訓練阿里巴巴開源模型 Qwen3.8,並以 Arete-27B 名義釋出。團隊的目標是調整模型處理政治敏感問題時的回應傾向;不過,所謂「去偏」或更符合某種世界觀,仍是訓練資料、評測題目與價值取捨共同塑造的結果,不能直接等同中立。
這件事對採用開源模型作本地部署或微調的開發者尤其有啟示:模型原有能力不必然決定最終輸出行為。若只用相對有限的監督式訓練資料便能顯著改變敏感題目的回答,企業在選型與上線前,便需要自行檢查模型在自身語境、風險範圍及使用情境中的表現。
約 5,000 萬 token 能改變甚麼
據 TechNews 科技新報 報道,Nous Research 認為部分中國開源模型的權重帶有與北京官方立場一致的行為傾向,例如面對 1989 年天安門事件等問題時,可能拒絕回答或迴避核心內容。團隊表示,Arete-27B 以約 5,000 萬 token 的監督式學習訓練後,已能明顯改變這類回應模式。
這項說法的技術重點不在於證明模型原先有單一、固定的「政治層」,而是顯示模型輸出的行為可以透過指令範例與標註答案重新校準。相同方法也可用於降低幻覺、調整安全回覆方式、改善特定產業知識的表達;但每一次校準同時會引入資料編寫者對何謂正確、足夠與安全的判準。
分數改善,仍需看評測設計
Nous Research 公布的內部結果顯示,Arete-27B 的事實性評分由 5 分滿分中的 2.32 分升至 2.98 分;被歸類為帶有政治宣傳色彩的回答比例則由 22% 降至 1%。團隊並稱,模型表現可與其測試過的其他西方模型相比。
這些數字可作為訓練方向有效的初步訊號,卻不足以單獨證明模型已客觀地減少偏向。事實性評分取決於題庫、參考答案與判分方法;「政治宣傳」的定義、樣本分布和評審準則,同樣會大幅影響比例。因此,這些均為 Nous Research 的內部評估,尚未經獨立第三方驗證。
較穩妥的做法,是把模型評估拆開進行:一組測試檢查可核實事實與引述來源,一組檢查模型是否能處理爭議議題而不逃避問題,另一組則檢查安全界線和拒答是否一致。若將所有結果壓縮成「去偏」分數,往往會掩蓋模型在不同語言、地區議題與 prompt 寫法下的差異。
教師模型也會影響答案邊界
TechNews 科技新報 指出,Nous Research 起初考慮採用 Nvidia 的 Nemotron 3 Ultra 作為教師模型,但因其處理中國相關議題時表現不夠穩定,最終改用 Thinking Machines Lab 開發的開源模型 Inkling。這個選擇說明,微調後模型繼承的不只是知識格式,也可能承接教師模型如何取捨論述、拒答與不確定性的方式。
報道未交代 Arete-27B、Qwen3.8 與 Inkling 的正式模型卡內容、授權條款及實際可下載狀態,因而未能據此判定開發者能否在不同商業或本地部署情境中使用。對有意評估同類模型的團隊而言,下一步應是檢視正式文件,並以自家語言、業務資料和高風險問題建立測試集,而非僅依據單一實驗室的整體分數作決策。
接下來值得觀察的是,是否有獨立研究以公開且可重現的方法,分別驗證 Arete-27B 的事實性、安全回應與敏感議題表現。這將有助分辨訓練帶來的是特定評測集上的優化,還是能跨情境維持的輸出改進。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- TechNews 科技新報 — 美 AI 實驗室「重新教育」阿里 Qwen 模型,擺脫中國言論審查、注入西方價值觀 — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。