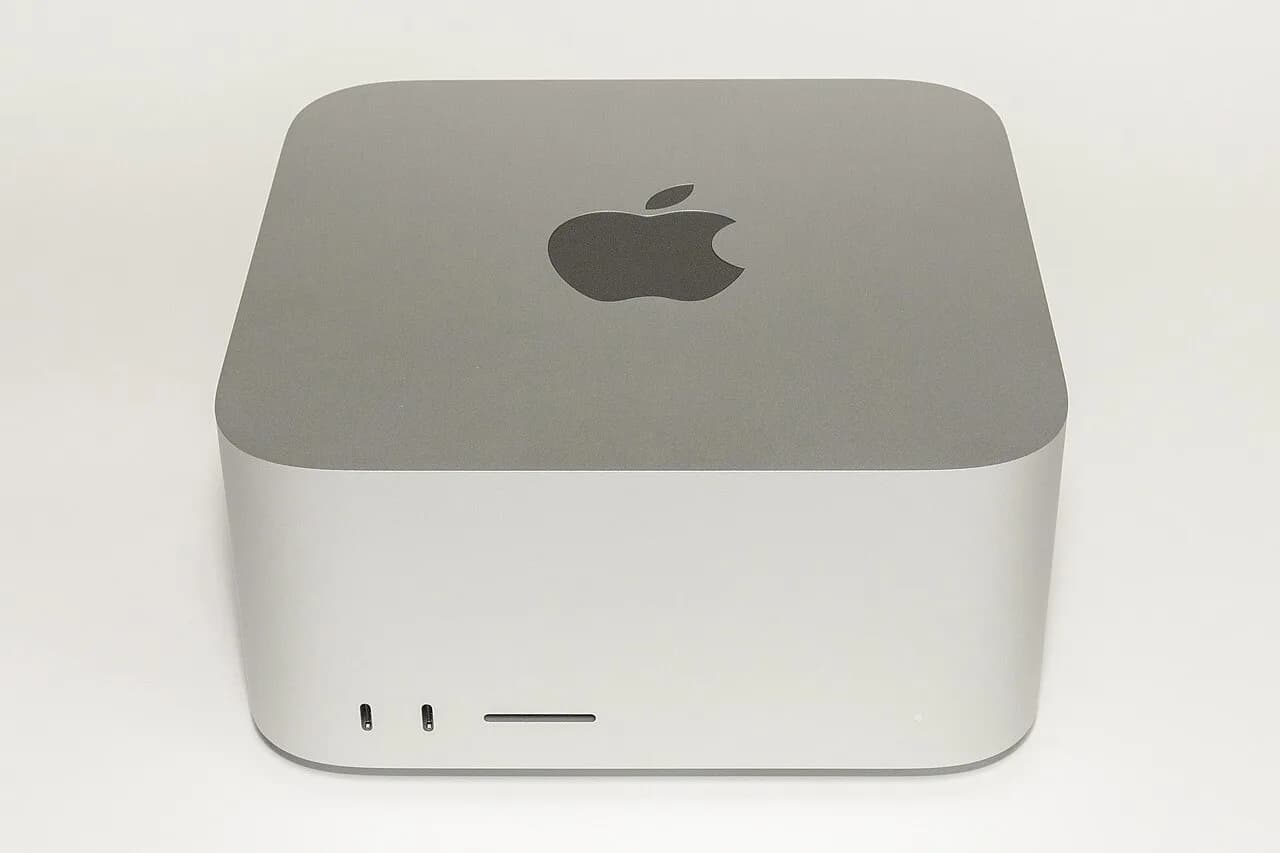
Mac Studio M5 Ultra 對 DGX Spark:本地 LLM 比拼的關鍵在推論設定
Tom's Hardware 報道以 Apple Mac Studio M5 Ultra 對 Nvidia DGX Spark,聚焦本地 AI 推論表現。對想把語言模型留在本機運行的創作者與開發者而言,這類比較有參考價值;不過,報道題目同時點出一個更重要的限制:模型愈大,推論引擎的設定組合(inference engine recipes)愈可能左右結果。
換言之,硬件平台的比較不能只化約為單一速度排名。即使使用同一部機,所選模型大小、量化方式及推論引擎配置不同,均可能令吞吐量、延遲與能否順利載入模型出現差異。這也是本地 LLM 實際部署中較容易被忽略的一環。
MLX stack 成熟,測試條件也更重要
報道把焦點放在 MLX stack 的成熟,以及較大模型對推論 recipe 的要求。從這個角度看,MLX 的價值不只在於讓 Mac 硬件參與本地 AI 工作流,也在於軟件層如何把模型與硬件配合起來。對使用者來說,模型能否運行只是第一步;能否以合適設定取得可接受的回應速度,才會影響它是否適合寫程式輔助、內容整理或其他日常工作。
這亦意味著,將測試結果套用到所有本地 AI 工作負載並不合適。不同模型、上下文長度、prompt 型態與推論引擎,未必得出相同排序。今次提供的來源資料未列出完整 benchmark 數字、測試設定或可重現步驟,因此較適宜把它視為一次針對特定軟件組合的比較,而非兩個平台的普遍定論。
選機前先界定工作流
若目標是本地運行 LLM,較實際的判斷次序是先界定常用模型與工作流,再檢查相應工具鏈是否成熟,以及是否有可參考的同類設定。對較大模型,尤其應留意推論引擎 recipe 是否已備妥;否則,硬件規格即使吸引,實際體驗仍可能受軟件配置限制。
接下來值得觀察的,是 MLX 及其他本地推論工具能否提供更清晰、可重現的模型設定範例,讓開發者可按自己的模型與工作需要比較平台。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- Tom's Hardware — Going deep on local AI performance benchmarking with Apple’s Mac Studio with M5 Ultra taking on Nvidia DGX Spark — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。