Adobe 實驗把相片變 3D 場景,AI 角色可直接「試戲」
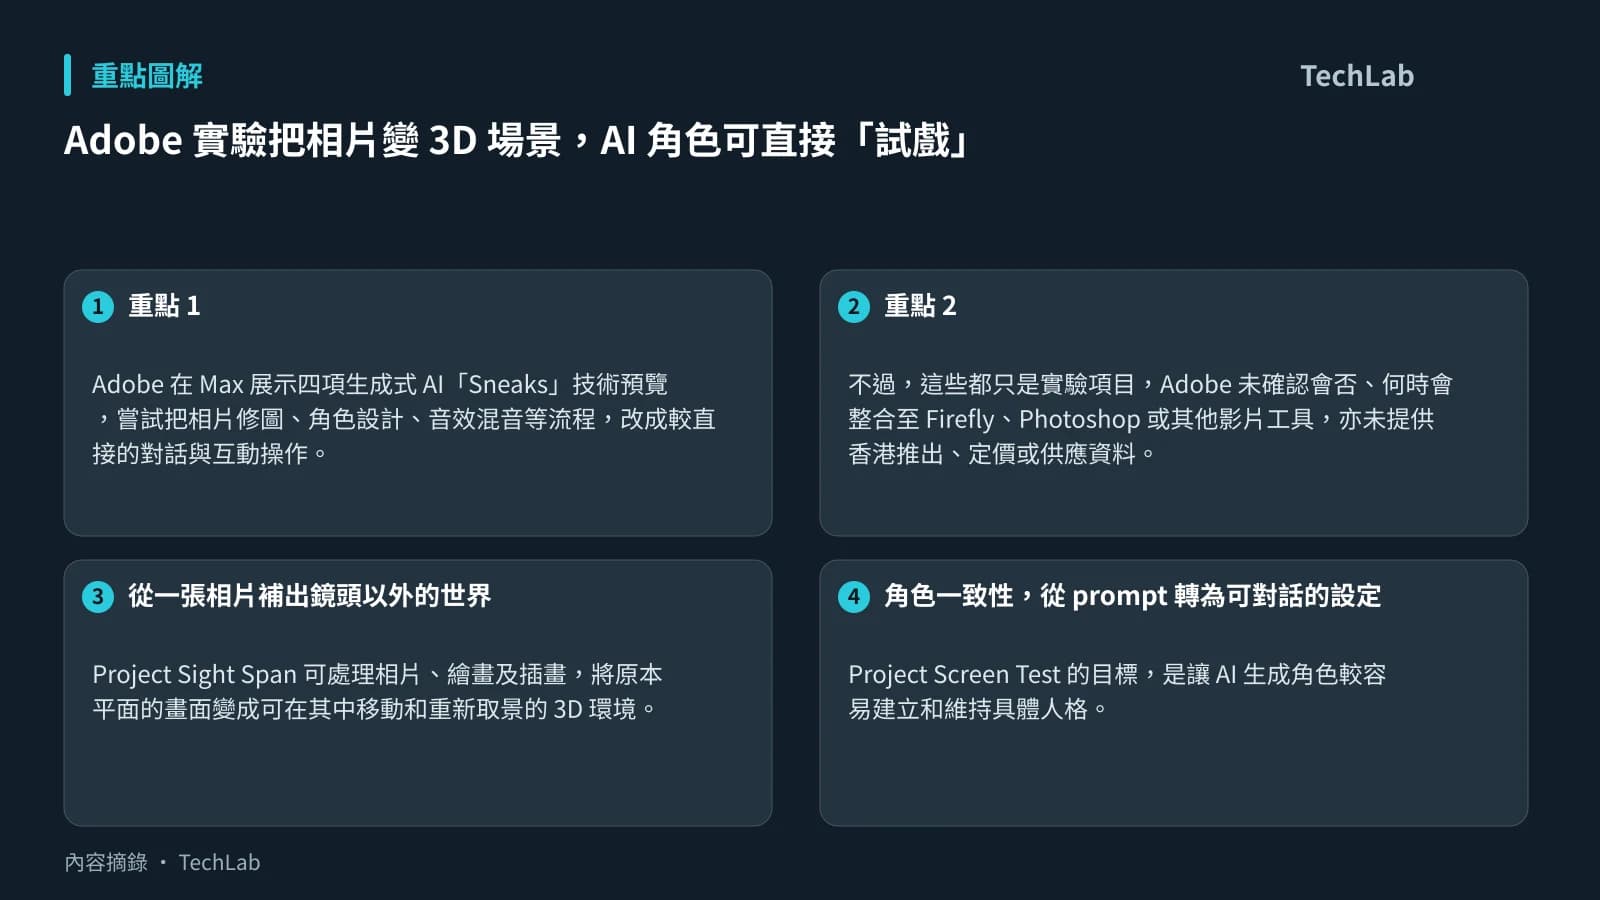
Adobe 在 Max 展示四項生成式 AI「Sneaks」技術預覽,嘗試把相片修圖、角色設計、音效混音等流程,改成較直接的對話與互動操作。其中,Project Sight Span 可把平面影像延展為可移動觀看的 3D 場景;Project Screen Test 則讓創作者以近似視像通話的方式,與 AI 生成角色交談並調校個性。
不過,這些都只是實驗項目,Adobe 未確認會否、何時會整合至 Firefly、Photoshop 或其他影片工具,亦未提供香港推出、定價或供應資料。對創作人而言,現階段較值得留意的不是功能看起來有多新奇,而是 Adobe 能否把這些生成能力變成可重複控制、可編輯,並能處理素材權利的工作流程。
從一張相片補出鏡頭以外的世界
Project Sight Span 可處理相片、繪畫及插畫,將原本平面的畫面變成可在其中移動和重新取景的 3D 環境。系統會生成原有畫框以外的物件和背景;即使用戶轉向觀看「身後」的範圍,畫面也會嘗試延續原圖內容。Adobe 表示,工具可保留並複製原有藝術風格,而人物相片中被重新定位的紋身及面部特徵,仍能保持與參考圖相近的辨識度。
這種能力可把單張圖像變成多角度素材,減少重新拍攝或逐格製作場景的需要。但代價也很清楚:鏡頭以外的內容本身由 AI 補全。報道指,使用者在 3D 空間移動時,視覺效果會較像素化和不清晰,選定角度後才恢復較高解像度。更重要的是,當拍攝位置可被大幅改變,成品是否仍可視為原本那張「相片」,會取決於使用者如何標示和使用這些生成部分。
角色一致性,從 prompt 轉為可對話的設定
Project Screen Test 的目標,是讓 AI 生成角色較容易建立和維持具體人格。創作者先輸入例如焦慮、害羞、尷尬等基本特質,再為角色選用預設聲音、以 prompt 描述聲線,或上載音訊樣本作參考;之後可透過交談補充背景、性格、目標、弱點、恐懼及動作習慣,最後以文字描述場景,生成角色的動畫試鏡片段。
這反映 Adobe 正嘗試處理生成式影片的一個實際限制:傳統動畫可逐項決定角色細節,AI 生成角色則往往較難穩定重現同一種個性和表現。把角色設定變成可交談、可手動調整的資料,理論上有助創作者更快試出方向;但能否在不同片段、不同場景維持一致,仍要待實際產品化後驗證。
聲音樣本的設計亦帶來權利管理問題。由於工具容許上載音訊作聲線參考,使用者及日後若將功能整合至正式產品的平台,均需釐清樣本是否獲授權、角色聲音是否可能造成混淆,以及生成內容的使用責任。這是基於已公布功能的風險分析,Adobe 在報道中未交代相關授權機制。
修圖與音效,改為「示範一次,再調整」
另外兩個項目較接近日常製作流程。Project Rinse Repeat 建基於 Photoshop,可把一次修圖操作套用至同一張相片的其他人物或物件,例如把為一人修走暗瘡的處理方式適配到其他人,或為不同大小和形狀的產品加入陰影。Adobe 指,套用後的結果仍以 Photoshop 原生工具重建,因此可繼續編輯。
Project Sound Bender 則讓使用者上載影片、以文字描述所需音效,再由系統生成並自動同步聲音。它提供一個方形的「聲音畫布」,四個角對應不同但相關的生成音效,用戶可拖動游標,即時調節各種聲音的比重,亦可自行更換各角落的音效。
Adobe 研究科學家 Gautham Mysore 向 The Verge 表示,這類較直覺的互動同樣是為了讓專業創作者更精確地運用判斷力,例如以 Sound Bender 探索聲音、以 Sight Span 調整鏡頭位置。若日後落地,真正的考驗會是這些介面能否保留足夠細緻的控制,而非只把複雜工序包裝成一次生成。
下一步值得觀察的是,Adobe 會否為這些預覽功能提供正式的整合路線、編輯控制及素材權利規則。對依賴素材庫、後期修圖、配音或角色製作的創作專業人士來說,這些安排會直接影響它們能否進入正式工作流程。
延伸閱讀
AI 輔助說明: 本文由 AI 協助整理。
參考來源
- The Verge — Adobe’s AI experiments let you walk around in photos and interview your characters — original report
本文根據原文及公開資料整理;資料有出入時,以原文及官方資料為準。